この記事は「ローカルLLM完全ガイド」の一部です。
ローカルLLMでClaude Codeのようなコーディングエージェントを動かすなら、モデル選びより先に「文脈長を64kにできるか」を確かめてください。OllamaはVRAM 24GiB未満だと既定の文脈長が4kで、Claude Codeの最初の依頼(約1万トークン)はエラーにならないまま約2割に切られました。
コード補完や短い相談なら、16GBのPCでも7B級のモデルで足ります。分かれ目になるのは、リポジトリを読ませて直させる「エージェント」の使い方です。この記事では、既定のまま繋いだときに実際に何が起きたかのログと、文脈長を伸ばすとメモリがどれだけ増えるかの数字から、「手元のメモリで、どこまでローカルに任せるか」を決めます。
結論(30秒)
- エージェント用途は文脈長64k以上が条件。Ollama公式もエージェントとコーディングツールには64000トークン以上を勧めている(2026年11月2日確認)
- Ollamaの既定はVRAMで決まり、24GiB未満なら4k。GPUのない検証用VMでは起動ログに
default_num_ctx=4096と出た - 既定4kのままClaude Codeを繋ぐと、最初の依頼10,080トークンが2,050トークンに切られた。Claude Codeは終了コード0で、依頼と無関係な答えを返した。画面にエラーは出ない
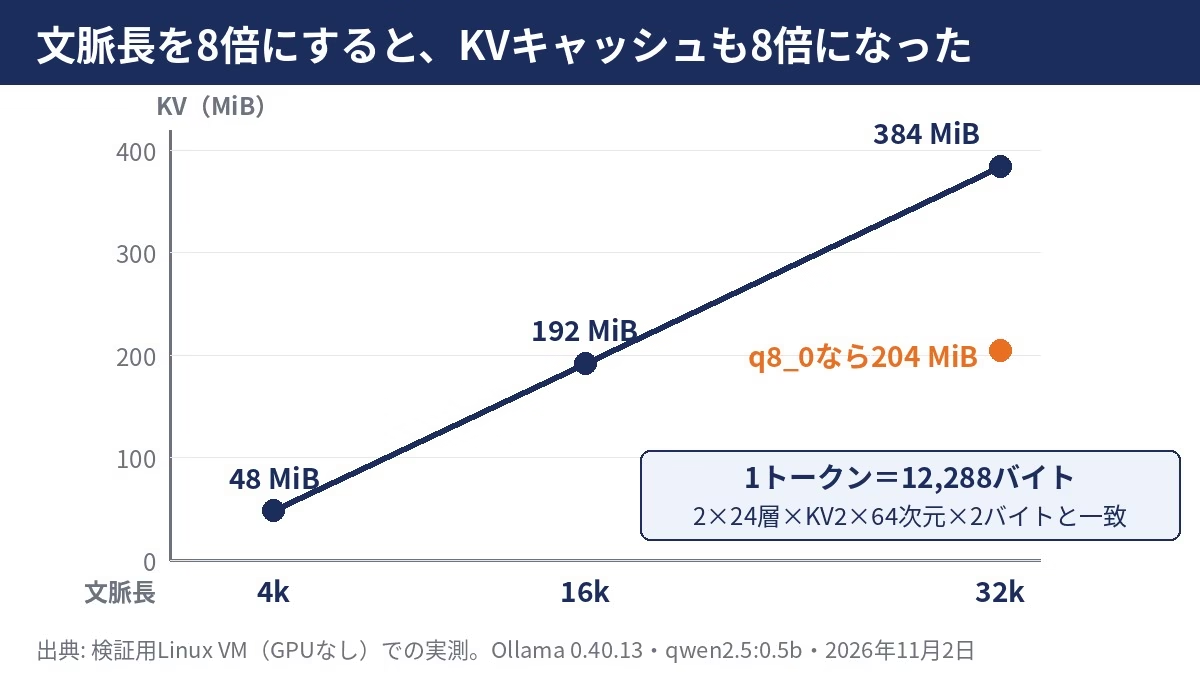
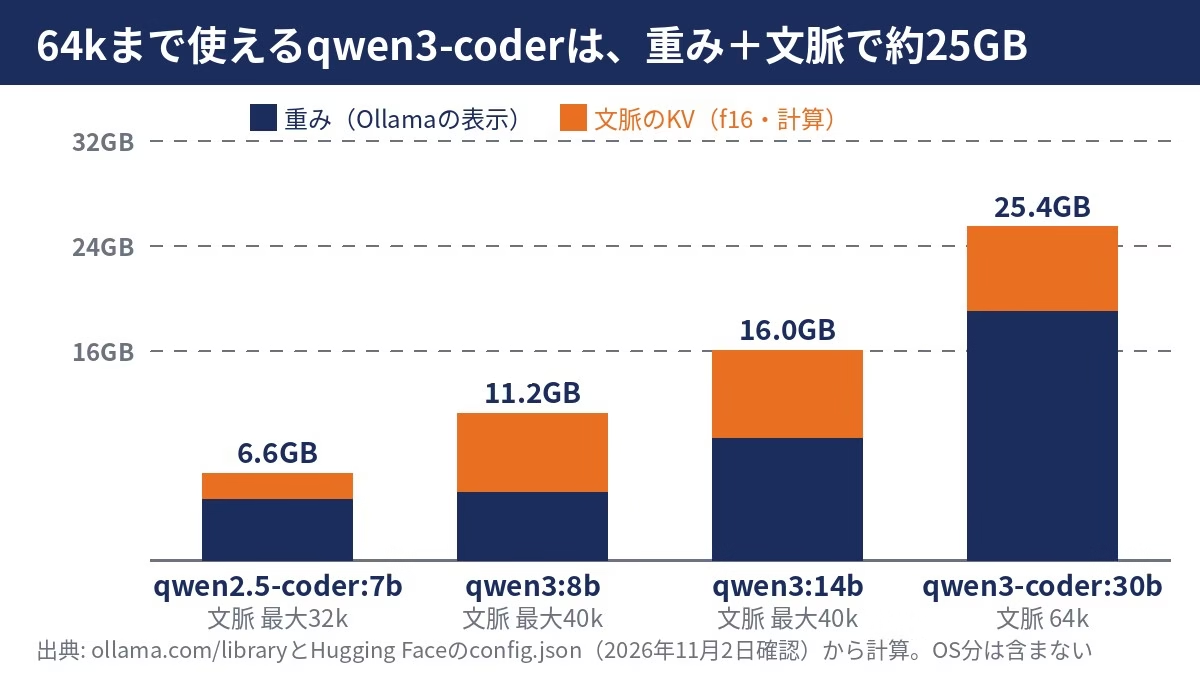
- 文脈長を伸ばすとKVキャッシュはその分だけ増える。4k→32kで48MiB→384MiB(ちょうど8倍)。64kで動く30B級のコーディングモデルは、計算で重み+文脈が約25GBになり、32GB以上のマシンが目安
製造業の社内IT担当として、「社内のコードを外に出さずにAIに書かせたい」と相談される立場から書いています。今回測ったのは、Linux・GPUなしの検証用VMで、小さなモデル(qwen2.5:0.5b)を使った「何トークン届いたか」と「メモリ」だけです。エージェントとしての品質と速度は測っていません。
既定のまま繋ぐと何が起きるか:依頼の8割が黙って消える
この節の要点: 既定4kのOllamaにClaude Codeを繋ぐと、依頼の頭から大半が捨てられます。止まらずに答えが返るので、設定の問題だと気づきにくいのが厄介です。
検証用のLinux VM(Debian 13、8 vCPU、メモリ16GB、GPUなし)に、Ollama 0.40.13とClaude Code 2.1.316を入れて、公式の手順どおりANTHROPIC_BASE_URL=http://127.0.0.1:11434で繋ぎました。作業フォルダはファイル2つだけの小さなリポジトリで、指示は「README.mdを読んで1行で要約して」です。
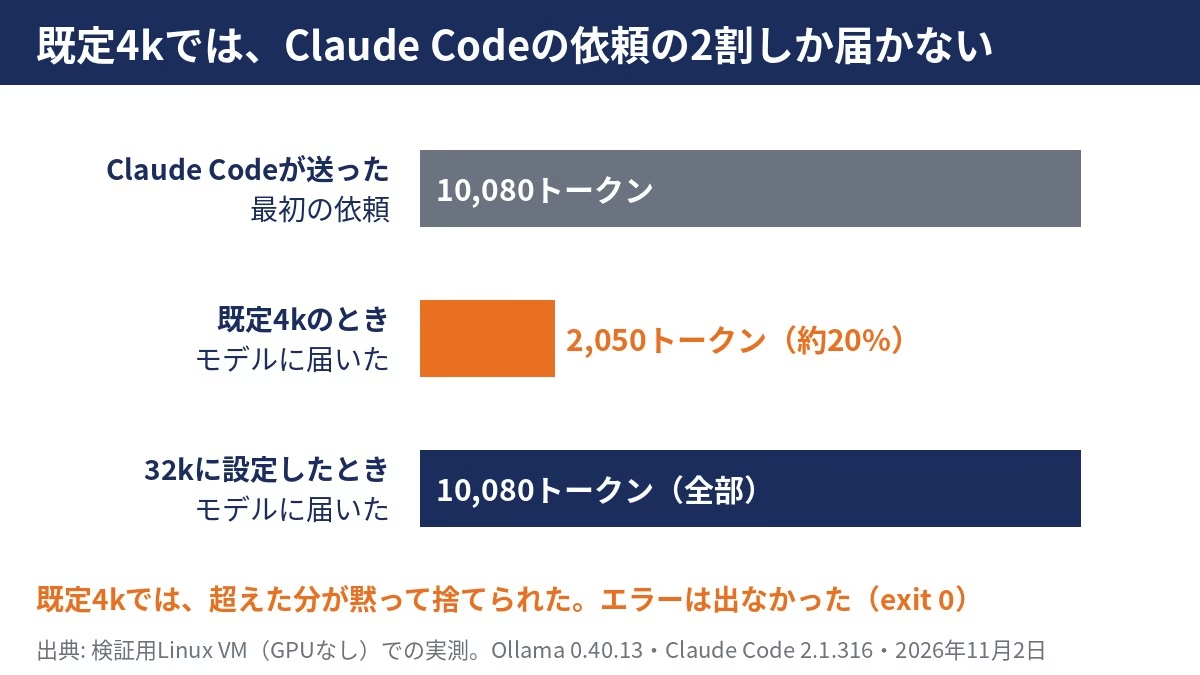
ファイル2つ、指示1行でも、Claude Codeが最初に送る依頼は10,080トークンありました(文脈長32kで受けたときのOllamaのログ)。ツールの説明やシステムの指示が先に積まれるためです。これを既定4kのOllamaが受けると、ログには次の2行が出ました。
truncating input messages which exceed context length truncated=1
truncating input prompt limit=2050 prompt=9809 keep=4 new=2050
モデルに渡ったのは2,050トークンです。Claude Codeは終了コード0で終わり、返ってきたのはREADMEの要約ではなく、関係のない文でした。画面には切り詰めの警告もエラーも出ません。
もう1つ、Claude Codeは起動時に次の警告を出していました。
Claude Code doesn't recognize the model "qwen2.5:0.5b", so it assumes a context window of 200k tokens.
Claude Codeは知らないモデル名を「文脈200k」とみなします。実際は4kしかないので、Claude Code側は「まだ余裕がある」と判断したまま会話を積み、Ollama側で黙って切られます。公式の設定(CLAUDE_CODE_MAX_CONTEXT_TOKENS)で本当の文脈長を教えると、この警告は消えました(後の手順で説明します)。
同じ依頼を文脈長32kで受けると、10,080トークンが切られずに全部モデルへ渡りました(ログはtruncated = 0)。最初の1往復だけで1万トークンです。ファイルを読み、コマンドの結果を受け取るたびに増えていくので、公式が64k以上を勧めるのは大げさではありません。
文脈長を伸ばすと、メモリはどれだけ増えるか
この節の要点: 増えるのは「KVキャッシュ」で、文脈長に比例します。1トークンあたりの量はモデルの設定値から計算でき、実測はその式どおりでした。
KVキャッシュは、モデルが読んだ文章を覚えておくための作業領域です(仕組みはKVキャッシュの解説記事に書きました)。量は次の式で決まります。
1トークンあたりのKV(f16)= 2(KとV)× 層の数 × KVヘッドの数 × ヘッドの次元 × 2バイト
| 文脈長(num_ctx) | KVキャッシュ(Ollamaのログ) | モデル全体(/api/psのsize) | メモ |
|---|---|---|---|
| 4,096(既定) | 48MiB | 648,722,512バイト | |
| 16,384 | 192MiB | 868,158,012バイト | |
| 32,768 | 384MiB | 1,103,039,036バイト | |
| 65,536を指定 | — | 1,103,039,036バイト | ollama psのCONTEXTは32768。モデルの最大長で頭打ち |
| 32,768+q8_0 | 204MiB | 914,326,813バイト | OLLAMA_KV_CACHE_TYPE=q8_0+Flash Attention。f16の53% |
前提: Ollama 0.40.13、qwen2.5:0.5b(24層・KVヘッド2・次元64)、検証用Linux VM(GPUなし)で2026年11月2日に測定。
48MiB÷4,096=12,288バイトで、式(2×24×2×64×2)と一致しました。式どおりに増えるので、手元にないモデルでも、設定ファイル(config.json)の4つの数字から必要なメモリを前もって計算できます。
表の4行目も大事です。65,536を指定しても、モデルの最大長が32,768なら32,768で止まります。エラーにはならず、ollama psのCONTEXT欄を見て初めて分かります。
モデル別:64kで動かすと何GBになるか
この節の要点: 64kを使えるモデルは限られ、使えるモデルは重みも大きい。16GBでエージェント用途を組むのは計算の上でも難しいです。
Hugging Faceの各モデルのconfig.jsonから1トークンあたりのKVを計算し、Ollamaのライブラリに載っている重みのサイズと足しました。
| モデル(Ollamaのタグ) | 重み | KV/トークン(f16) | モデルの最大長 | 最大長(または64k)でのKV | 合計の目安 |
|---|---|---|---|---|---|
| qwen2.5-coder:7b | 4.7GB | 57,344バイト | 32,768 | 32kで約1.9GB | 約6.6GB(64kには届かない) |
| qwen3:8b | 5.2GB | 147,456バイト | 40,960 | 40kで約6.0GB | 約11.2GB(64kには届かない) |
| qwen3:14b | 9.3GB | 163,840バイト | 40,960 | 40kで約6.7GB | 約16.0GB(64kには届かない) |
| qwen3-coder:30b | 19GB | 98,304バイト | 262,144 | 64kで約6.4GB(q8_0なら約3.4GB) | 約25.4GB(q8_0なら約22.4GB) |
前提: 重みはollama.com/libraryの表示、KVはconfig.json(2026年11月2日確認)からの計算。64kは65,536トークンで計算。OS・ほかのアプリ・計算用のバッファの分は含まないので、実際にはこれより多く要ります。q8_0の比率は上の実測(53%)を使いました。
ここから言えるのは2つです。1つは、小さいモデルは「メモリが足りない」より先に「最大長が足りない」こと。7〜14B級はメモリには収まっても、最大長が32k〜40kで64kに届きません。もう1つは、64kを使える30B級は重み+文脈で20GBを超えることです。16GBのMacでqwen3-coder:30bを動かした例は4ツールの比較記事にありますが、毎秒0.20トークンで実用の速さにはなりませんでした。
判断表:メモリ別に、どこまでローカルに任せるか
この節の要点: 補完と相談はメモリが小さくてもローカルで回せます。エージェントは、64kの文脈を載せられるかで線を引きます。
| 使えるメモリ(GPU/ユニファイドメモリ) | コード補完・短い質問(〜8k) | コードを貼って相談(〜32k) | エージェント(Claude Codeなど、64k以上) |
|---|---|---|---|
| 16GB | ○7B級(qwen2.5-coder:7bで約5GB) | ○7〜8B級(32kで約6.6〜10GB) | ×64kを使えるモデルが載らない。クラウドか社内サーバーへ |
| 24GB | ○ | ○14B級まで(qwen3:14b 32kで約14.7GB) | △30B級はq8_0でも計算で約22.4GB。OSの分を足すと余裕がない |
| 32GB | ○ | ○ | ○30B級を64kで(f16で約25.4GB)。ほかの重いアプリは閉じる |
| 48GB以上 | ○ | ○ | ○30B級を128kまで(計算で約31.9GB) |
前提: メモリの数字はconfig.jsonとollama.com/libraryからの計算で、OS・アプリ・計算用バッファの分を含まない。エージェントとしての品質と速度は測っていない。
社内で使う立場から付け足すと、「コードを社外に出さない」ことが目的なら、16GBのPCを全員に配ってエージェントを動かすより、補完と相談は手元で、エージェントは32GB以上の社内サーバー1台に寄せるほうが現実的です。16GBのMacでどのモデルが日本語で使えるかは16GB Macの日本語LLM選びにまとめています。
文脈長の設定手順(Mac/Linux/Windows)と確かめ方
この節の要点: Ollama側で文脈長を上げ、Claude Code側には本当の文脈長を教えます。最後にollama psのCONTEXT欄で確かめます。
Ollama側:文脈長を64kにする
- Macのアプリ: Ollamaの設定画面にある文脈長(Context length)のスライダーを動かす(公式の手順)
- Macでコマンドから:
launchctl setenv OLLAMA_CONTEXT_LENGTH 65536を実行してから、Ollamaのアプリを再起動する - Linux(systemd):
sudo systemctl edit ollama.serviceで開いた画面に次を書き、sudo systemctl daemon-reload && sudo systemctl restart ollama
[Service]
Environment="OLLAMA_CONTEXT_LENGTH=65536"
- Windows: タスクバーからOllamaを終了し、「環境変数を編集」で自分のアカウントに
OLLAMA_CONTEXT_LENGTH=65536を追加して、Ollamaを起動し直す - その場で試すだけなら:
OLLAMA_CONTEXT_LENGTH=65536 ollama serve
メモリが厳しいときは、OLLAMA_KV_CACHE_TYPE=q8_0を足すとKVキャッシュが約半分になります(公式FAQ。今回の実測では53%)。Flash Attentionが使える環境で効きます。
Claude Code側:本当の文脈長を教える
export ANTHROPIC_BASE_URL=http://localhost:11434
export ANTHROPIC_AUTH_TOKEN=ollama
export ANTHROPIC_API_KEY=""
export CLAUDE_CODE_MAX_CONTEXT_TOKENS=65536
claude --model qwen3-coder:30b
CLAUDE_CODE_MAX_CONTEXT_TOKENSは、Claude Codeが知らないモデルの文脈長を指定する環境変数です(Claude Codeの公式ドキュメント)。指定すると、Claude Codeはその長さを前提に会話の要約(compaction)を進めます。Ollamaのollama launch claudeで起動する方法もあります。
確かめる
モデルを1回動かしてから、ollama psを実行します。公式ドキュメントに載っている出力例は次の形です(モデルは公式の例のまま)。
NAME             ID              SIZE      PROCESSOR    CONTEXT    UNTIL
gemma4:latest    c6eb396dbd59    9.6 GB    100% GPU     131072     2 minutes from now
- CONTEXTが設定した値になっているか。小さければ、設定が効いていないか、モデルの最大長で頭打ちになっている
- PROCESSORが
100% GPUか。CPUの割合が出ていたら、メモリに収まらず一部がCPUに回っている。公式も「CPUへ逃がさないように」と書いている - Claude Codeの起動時に「assumes a context window of 200k tokens」の警告が消えているか
症状から直す場所を探す
この節の要点: 文脈長の問題は、エラーではなく「答えがおかしい」形で出ます。ログの文言で見分けます。
| 症状 | どこに何が出るか | 原因 | 直す場所 |
|---|---|---|---|
| 依頼と関係ない答えが返る。エラーは出ない | Ollamaのログにtruncating input prompt limit=2050 prompt=9809 | Ollamaの文脈長が既定4kのまま | OLLAMA_CONTEXT_LENGTHかアプリのスライダー |
| 64kにしたのに直らない | ollama psのCONTEXTが32768など小さい | モデルの最大長で頭打ち | 最大長の長いモデルに替える |
| 起動時に「assumes a context window of 200k tokens」 | Claude Codeの画面 | Claude Codeがモデルを知らず200kとみなしている | CLAUDE_CODE_MAX_CONTEXT_TOKENS |
| 文脈長を上げたら極端に遅くなった | ollama psのPROCESSORにCPUの割合 | 重み+KVがメモリに収まらない | 文脈長を下げる/OLLAMA_KV_CACHE_TYPE=q8_0/小さいモデル |
やらないほうがいいこと
- 「エラーが出ないから動いている」と判断しない。今回の既定4kの実行は、終了コード0で答えも返りました。切られたかどうかはOllamaのログか
ollama psでしか分かりません - 文脈長をとりあえず最大にしない。256kなどにすると、KVがメモリからあふれてCPUに回り、かえって使えなくなります。64kから始めて、PROCESSORが
100% GPUのままかを見て上げます - 公式FAQの「既定は4096」だけを見て判断しない。FAQにはそう書いてありますが、文脈長のページではVRAMに応じて4k/32k/256kに変わると書かれています(2026年11月2日確認)。自分の環境の値は
ollama psかログで確かめます
導入前に確かめること(チェックリスト)
- [ ] 何に使うかを決めた(補完・相談だけか、エージェントまでか)
- [ ] 使うモデルのconfig.jsonで最大長を見た(64k以上あるか)
- [ ] 重み+64kのKVを計算し、メモリに収まるかを見た(OSの分を残して)
- [ ] Ollamaの文脈長を設定し、
ollama psのCONTEXTで確かめた - [ ] PROCESSORが
100% GPU(MacならGPU側)のままかを見た - [ ] Claude Codeに
CLAUDE_CODE_MAX_CONTEXT_TOKENSを設定し、200kの警告が消えたのを見た - [ ] 最初の数回はOllamaのログで
truncatingが出ていないかを見た
FAQ
Q1. ローカルLLMでClaude Codeは実用になりますか?
A. 文脈長64k以上を確保できるメモリ(計算では32GB以上が目安)があれば、試す価値があります。既定の4kのままでは、最初の依頼の約2割しかモデルに届かず、まともに動きません。品質と速度は今回測っていないので、自分のリポジトリで小さな作業から確かめてください。
Q2. コーディング用のローカルLLMに必要なメモリは?
A. 補完や短い質問なら16GBで7B級が動きます。エージェント用途で64kを使える30B級(qwen3-coder:30b)は、重み19GB+KV約6.4GBで約25.4GB(計算値、OSの分を除く)なので、32GB以上が目安です。
Q3. Ollamaのコンテキスト長(num_ctx)はどう変えますか?
A. 環境変数OLLAMA_CONTEXT_LENGTHを設定してOllamaを再起動します(Macはアプリの設定のスライダーでも変えられます)。API経由ならnum_ctxをリクエストに入れます。効いたかどうかはollama psのCONTEXT欄で確かめます。
Q4. 16GBのMacでローカルLLMのコーディングはできますか?
A. 補完と、コードを貼っての相談はできます。エージェントは、64kを使えるモデルが16GBに収まらないので、計算の上でも難しいです。手元は補完と相談、エージェントはクラウドか社内サーバーという分け方をおすすめします。
Q5. 文脈長を伸ばすと何が増えますか?
A. KVキャッシュです。今回の測定では4k→16k→32kで48→192→384MiBと、文脈長に比例して増えました。1トークンあたりの量は「2×層×KVヘッド×ヘッド次元×2バイト」で計算できます。
まとめ
ローカルLLMでコーディングをするとき、補完と相談は小さいメモリでも回ります。エージェントに任せるかどうかは、「64kの文脈を載せられるか」で決まります。Ollamaは既定のままだと4kで、Claude Codeの依頼は黙って切られました。設定するのは、OllamaのOLLAMA_CONTEXT_LENGTHと、Claude CodeのCLAUDE_CODE_MAX_CONTEXT_TOKENSの2つです。
まだ確かめていないのは、Macでの既定値(ユニファイドメモリをどう数えるか)と、GPUのある環境で64kにしたときの速度と品質です。測れたら追記します。
関連記事
- Claude CodeでローカルLLMを使う4つのツール(Mac)
- Goose×Ollamaでローカルのコーディングエージェントを組む
- Bonsai 2 27Bを16GBのMacで実測
- Qwen3.8 27Bの量子化の崖(16GB Mac)
- 16GB Macで日本語ローカルLLMを選ぶ
- KVキャッシュとは何か
- ハブ: ローカルLLM完全ガイド
参考(一次ソース)
- Ollama: Context length(VRAM別の既定値、64000以上の推奨、ollama ps)(2026年11月2日確認)
- Ollama: Claude Code(接続手順、64k以上の推奨)(2026年11月2日確認)
- Ollama FAQ(環境変数の設定方法、KVキャッシュの量子化)(2026年11月2日確認)
- Claude Code: Model configuration(CLAUDE_CODE_MAX_CONTEXT_TOKENS)(2026年11月2日確認)
- Hugging Face の config.json(Qwen3-Coder-30B-A3B-Instruct/Qwen3-8B/Qwen3-14B/Qwen2.5-Coder-7B-Instruct)(2026年11月2日確認)
- Ollama library(各モデルの重みのサイズ)(2026年11月2日確認)
更新履歴
- 2026-11-02: 初版(Ollama 0.40.13・Claude Code 2.1.316、検証用Linux VM(GPUなし)で測定)
確認日: 2026-11-02
コメント