この記事は「ローカルLLM完全ガイド」の一部です。
「無料のAPIに社内のPDFを投げるのは怖い。自前のGPUで動かせば、読み取りの精度も上がるんじゃないか」。
前半は正しく、後半は外れていました。同じオープン重みのモデルで、同じPDFを無料の試用APIと自前のGPUにかけたところ、出てきたMarkdownは1バイトも違いませんでした。誤読した箇所まで同じです。自前にする理由は品質ではなく、PDFを外に出せるかどうかと、枚数の多さです。
TL;DR: 2026年10月25日に私が実測。無料試用APIは約6秒/頁、RunPodのA40 48GBで自己ホストすると約9秒/頁。出力Markdownのmd5は一致。自前の1ページ目までにはセットアップ込みで約55分・約$0.54かかりました。
結論(30秒)
- 同じ重みなら、自己ホストしても読み取り品質は上がらない。出力はmd5まで一致し、誤読も同じだった
- 無料試用APIの弱点は、PDFが手元を離れること。保存期間の記載がなく、本番利用は推奨されていない(2026年10月25日確認)
- 数枚を試すなら無料試用APIで足りる
- 自前にするのは「外に出せない」「閉域」「大量に流す」のどれかに当たるときだけ
製造業の社内IT担当として、「この資料をAIに読ませてよいか」を相談される立場から書いています。測ったのはPDF 1ページ・1ファイルだけです。日本語OCR全般の精度比較ではありません。
自前のGPUで動かしても、出力は1バイトも変わらなかった
文書解析AIはPDFや画像を読んで、見出し・本文・表を構造つきのテキストに起こすモデルです。今回のモデルは重み(学習済みのファイル)が公開されていて、開発元が無料の試用APIも出しています。同じ重みを、借りたGPUの上でも動かせます。再現用に名前を1回だけ書くと、SoMarkのOXR-1.0(1.3Bパラメータ)です。
入力にしたのは、私の手元にあった1ページのPDFです。暗号化がかかっていて、テキストのコピーができない索引表でした。中身は社外に出せる性質のものではないので、文言はここに載せません。
| 項目 | 無料試用API | 自己ホスト |
|---|---|---|
| 動かした場所 | 開発元のサーバー(free-oxr.somark.ai) | RunPodのNVIDIA A40 48GB(Secure Cloud) |
| 重み | 同一のオープン重み | 同一のオープン重み |
| 呼び出し・推論エンジン | Macから somark 0.1.0 で送信 | vllm 0.25.1 + transformers 5.13.1 |
| 1ページの所要時間 | 約6秒 | 約9秒(GPU側の解析) |
| 費用 | 0円 | $0.59/時。セットアップ込み約55分で約$0.54 |
| VRAM | — | 解析後 約35GB / 46GB |
| 出力Markdownの md5 | 3b7d46840148ba5134b472d1effda628 | 3b7d46840148ba5134b472d1effda628 |
前提: 2026年10月25日(日本時間)に私が測定。同一PDF 1ページ・1回ずつ。料金はRunPodのA40のページで2026年10月25日に確認したSecure Cloudの値。
この表で見てほしいのは最後の行です。md5はファイルの中身から計算する短い指紋のような値で、1文字でも違えば別の値になります。それが2つとも同じでした。改行の位置も、表の書き方も、全部同じです。
速さは無料試用APIのほうが速く出ました。ただ、無料試用APIは返ってくるまでの壁時計、自己ホストはGPU側の解析時間です。1回ずつなので、速さは比べられません。
誤読まで同じ形で出た。精度を決めるのは置き場所ではなく重みだった
出力が同じなら、間違いも同じです。
今回の1ページには、日本語の誤読がいくつもありました。カタカナ語の長音や小さい文字がゆれる。日本語の漢字が形の似た簡体字に置き換わる。ページ下の注意書きのあたりに、中国語の語句が混ざる。表の外の本文ブロックほど崩れが大きく、表の中の英数字の番号はほぼ正確でした。
自前のGPUに移しても、1つも直りませんでした。
考えてみれば当然です。精度を決めているのは重みと前処理で、マシンの置き場所ではありません。ただ、GPUの種類や推論エンジンのバージョンが違えば、計算の細かい誤差で出力が揺れることもあります。だから確かめる価値がありました。今回は揺れませんでした。
精度を上げたいなら、打ち手は別にあります。重みを変える、別のエンジンの出力と突き合わせる、人が校正する。このどれかです。
なお、表はMarkdownの | 区切りではなく、HTMLの <table> で出てきました。これも両方同じです。後段のプログラムが | の表しか読めないなら、どちらを選んでも手当てが要ります。
無料試用APIの弱点は品質ではなく、PDFが手元を離れること
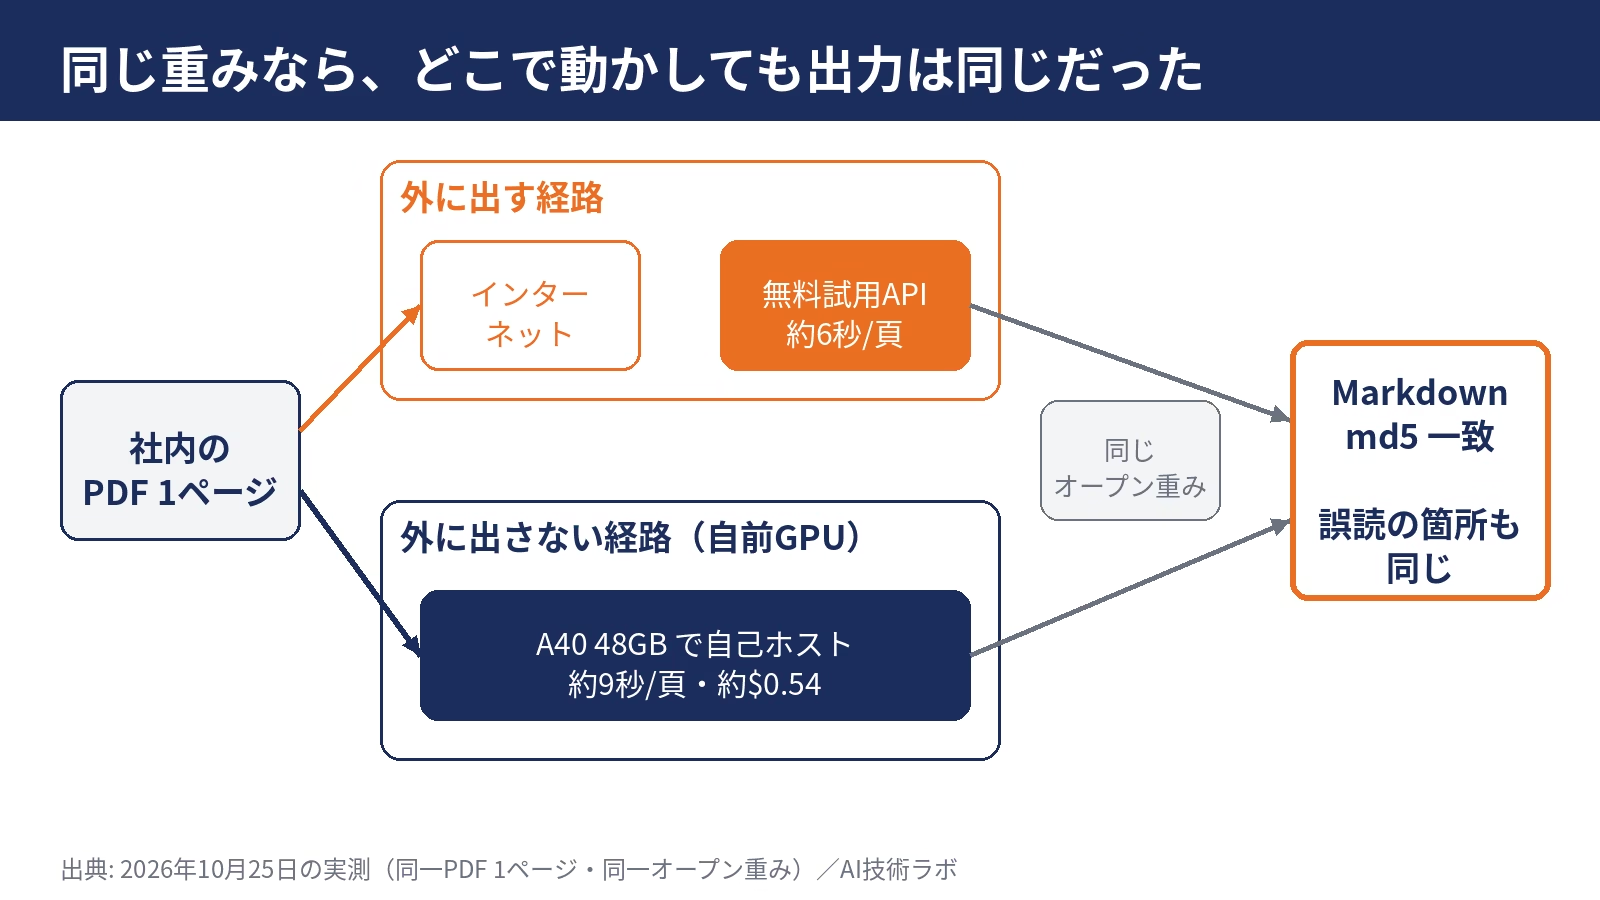
品質が同じなら、何が違うのか。データの行き先です。
無料試用APIに投げたPDFは、インターネットを通って開発元のサーバーで処理されます。公式ドキュメントを2026年10月25日に確認した範囲では、次のとおりでした。
- APIキーは要らない。
dummyのような仮の値でよい - 1ファイル10MB・1リクエスト20ページまで。リクエストはキューに並ぶので、処理速度は多少ばらつく
- アップロードした文書や結果を、どれだけの期間保存するかは書かれていない
- 「本番での利用は推奨しない」「サービスの安定性は保証しない」と明記している
キーが要らないのは、試す側には楽です。裏返すと、誰が何を送ったかを会社として管理できません。外部送信の前に保存期間と用途を確かめる規程がある会社では、送ってよい先に入りません。
逆に、社外に出しても困らない資料なら、この弱点は問題になりません。品質が同じなので、GPUを借りる理由がなくなります。
自前の1ページ目までに55分。払ったのは$0.54、時間の大半はインストールだった
では、自前にするとどれくらい手間がかかるのか。私がRunPodで1ページ目を出すまでの記録です(壁時計の目安。途中の失敗を含む)。
モデルのダウンロードは約3.0GBで約15秒。ここは一瞬です。時間を食ったのは、推論エンジン(vLLM)と周りのライブラリのpipインストールで、約20分。仮想環境だけで約16GBになりました。vLLMの起動にさらに約5分。モデル自体の読み込みは10秒ほどで、残りは初期化です。解析APIの起動は約10秒、1ページの解析は約9秒でした。Podの稼働は合計約55分です。
お金は$0.54で済みました。ただ、55分のうち解析は9秒です。毎回GPUを借りてインストールからやり直すなら、払っているのはほぼ待ち時間です。
つまずいた3か所と直した場所
詰まったのは3回です。どれもモデルの問題ではなく、借りたGPUサーバーの環境の問題でした。
| 症状 | 原因 | 直した場所 |
|---|---|---|
| PodにDockerを入れても、dockerdが起動しない(公式推奨のDocker一体型が使えない) | Pod自体がコンテナの中で、Dockerを入れ子で動かす権限(iptables・ブリッジ)がない | Dockerをやめ、ソースから3つのサービスを個別に起動した |
| 初回のvLLM起動が失敗する | システムに ninja が入っておらず、起動時のJITコンパイルが通らない | apt install ninja-build を入れてから再起動 |
| サービスが既定のポートで立ち上がらない | RunPod側のnginxが8081番などを先に使っている | layout解析を18081、vLLMを18080、解析APIを8000に変えた |
前提: 公式の既定ポートはOXRモデル8080・layout解析8081・解析API8000(GitHubのREADME、2026年10月25日確認)。
ninjaは、vLLMが使うflashinferが起動時にコンパイルするときに要ります。vLLMの起動には約5分かかるので、最初に入れておけば、その待ちを1回分省けます。
apt install -y ninja-build自前にするのは「外に出せない」と「量が多い」のときだけ
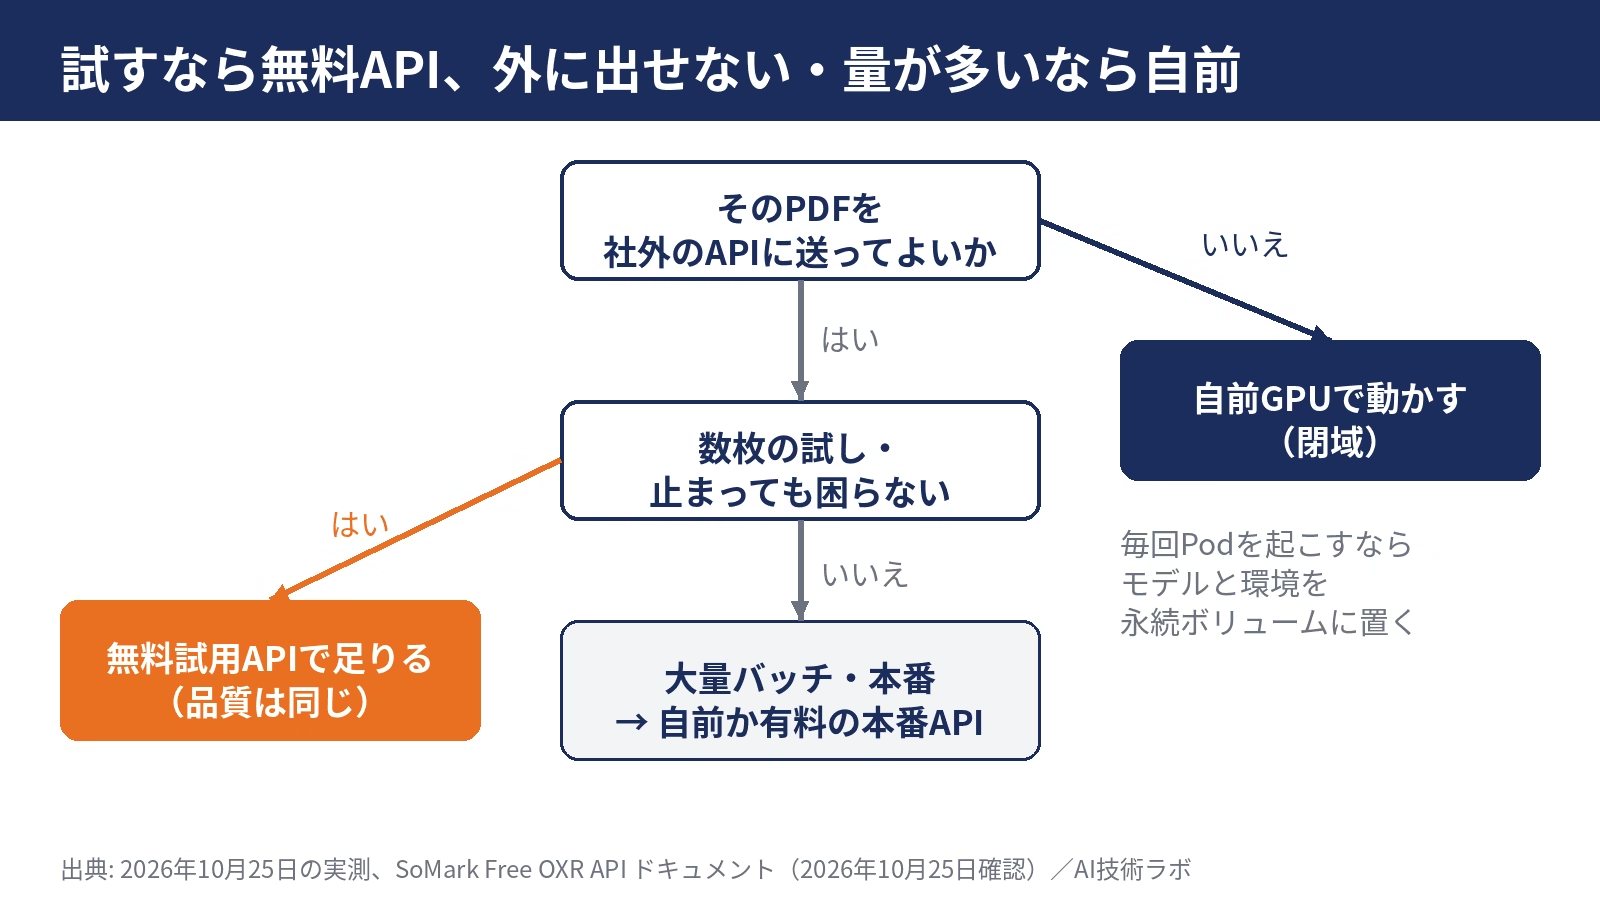
ここまでの結果を読者の条件ごとに並べ直します。行が手元の状況、列が選択肢です。
| 手元の状況 | 無料試用API | 自前のGPU |
|---|---|---|
| 公開資料・社外に出してよい資料を、数枚試したい | これで足りる(品質は同じ・準備ゼロ) | 過剰。起動までの時間が支配的 |
| 社外秘で、外部送信の可否がまだ決まっていない | 規程の確認が済むまで保留 | 確認で通らなければ候補 |
| 規程や顧客との契約で、社外に出せないPDF | 使えない | 自前で動かす |
| ネット接続そのものが禁止の閉域 | 使えない | 自前(社内のGPU) |
| 数千ページの大量バッチ・止まると困る業務 | 不向き(本番非推奨・20ページ上限・キューあり) | 候補。モデルと環境を永続ボリュームに置く |
前提: 2026年10月25日の実測と、無料試用APIの公式ドキュメント(同日確認)からの整理。社外に出してよいかは、社内規程と顧客との契約が優先します。
データを外に出してよい大量バッチなら、開発元の有料の本番サービス(公式では1ファイル200MB・300ページまで)もあります。この記事では試していません。
製造業で迷いやすいのは3行目です。顧客から預かった図面や仕様書は、自社の規程より先に契約が効きます。ここで自前を選ぶ理由は「精度が上がるから」ではなく「契約上、外に出せないから」。稟議の理由もこちらで書くほうが筋が通ります。
この実測で言えること、言えないこと
言えるのは1つだけです。同じオープン重みを使う限り、無料試用APIと自己ホストで出力は変わらなかった。この1ページについては、バイト単位で確かめました。
言えないことのほうが多くあります。測ったのは1ページ・1ファイルで、誤読の傾向が他の文書でも同じかは分かりません。私のMacにはNVIDIAのGPUがないので、手元でのローカル推論は試していません。公式は低負荷の試験なら24GBのGPUから、長い文書や同時処理には48GB以上を推奨しています。今回の約35GBは観測値で、最低限必要な量ではありません。
それでも、「自前にすれば精度が上がるか」という問いには、この1ページで十分に答えが出ました。上がりません。
稟議の前に確かめる6項目
- [ ] 解析にかけたいPDFを「公開してよい」「社外秘」「顧客から預かったもの」「閉域の中にしかないもの」に分けたか
- [ ] 社外秘以上の資料について、送信先の保存期間と用途が規程の条件を満たすか確かめたか
- [ ] まず公開資料で無料試用APIにかけ、品質が用途に足りるかを見たか(自前にしても品質は同じ)
- [ ] 誤読が許されない用途なら、人の校正か別エンジンとの突き合わせを工程に入れたか
- [ ] 後段のプログラムが、HTMLの
<table>で出てくる表を読めるか - [ ] 自前にするなら、モデルと環境を永続ボリュームに置き、Dockerが動くか・
ninja-buildがあるかを先に確かめたか
よくある質問
Q. 無料試用APIに社内のPDFを送っても大丈夫ですか?
社内規程しだいですが、慎重に考えたほうがよい先です。公式ドキュメントに保存期間の記載がなく、本番利用は推奨されていません(2026年10月25日確認)。公開資料で品質を確かめる用途に留めるのが無難です。
Q. 自己ホストの費用はどれくらいですか?
今回はRunPodのA40 48GB(Secure Cloud、$0.59/時)で、セットアップ込み約55分・約$0.54でした(料金は2026年10月25日確認)。費用より重いのは時間のほうです。
Q. Macでローカルに動かせますか?
この記事では試していません。公式の動作条件はNVIDIAのGPU(BF16対応)とLinuxで、私のMacにはNVIDIAのGPUがないためです。
まとめ
同じオープン重みで、無料試用APIと自前のGPUに同じPDFを流すと、出力は1バイトも変わりませんでした。自己ホストは品質を上げる手段ではなく、データを手元に留める手段です。外に出せるPDFを数枚試すだけなら、無料試用APIで足ります。GPUを借りるのは、PDFを外に出せないと決まったときか、毎日大量に流すと決まったときです。
残っている問いは、他の文書でも誤読の傾向が同じかどうかです。1ページでは、そこまでは分かりません。
関連記事
参考(一次ソース)
- RunPod「A40」GPUの料金ページ(Secure Cloud $0.59/時、2026年10月25日確認)
- SoMark ドキュメント「Free OXR API」(無料試用APIの上限・本番非推奨、2026年10月25日確認)
- SoMarkAI/OXR(GitHub)(動作条件・起動方法・既定ポート、2026年10月25日確認)
更新履歴
- 2026-10-28: 初版
確認日: 2026-10-25
コメント