「27Bクラス、16GBのMacじゃ無理だよなあ」 – その諦め、9割方は正解です。
普通のやり方では物理的に不可能でした。Q4に量子化しても重みだけで17GB。16GBのMacに積んだ瞬間、スワップに8GBが溢れて、10分待っても256トークン出てこない。ファンは唸り、カーソルは重くなる。結論は「動かない」でした。
TL;DR: 16GB Macで27Bを動かす道は今のところ1つ。三値量子化モデルの Bonsai 2 27B(実ファイル5.95GB)です。形式を選べば 14.6 tok/s — 12Bモデル(gemma4)と肩を並べる速度です(2026年9月・単発測定)。
測定環境: MacBook M5(ベース)16GB / macOS 26.6.2 / llama.cpp fork prism-b10709-9a9394a / Ollama。固定プロンプト(約102トークンの要約依頼)で256トークン生成、すべて単発測定です。
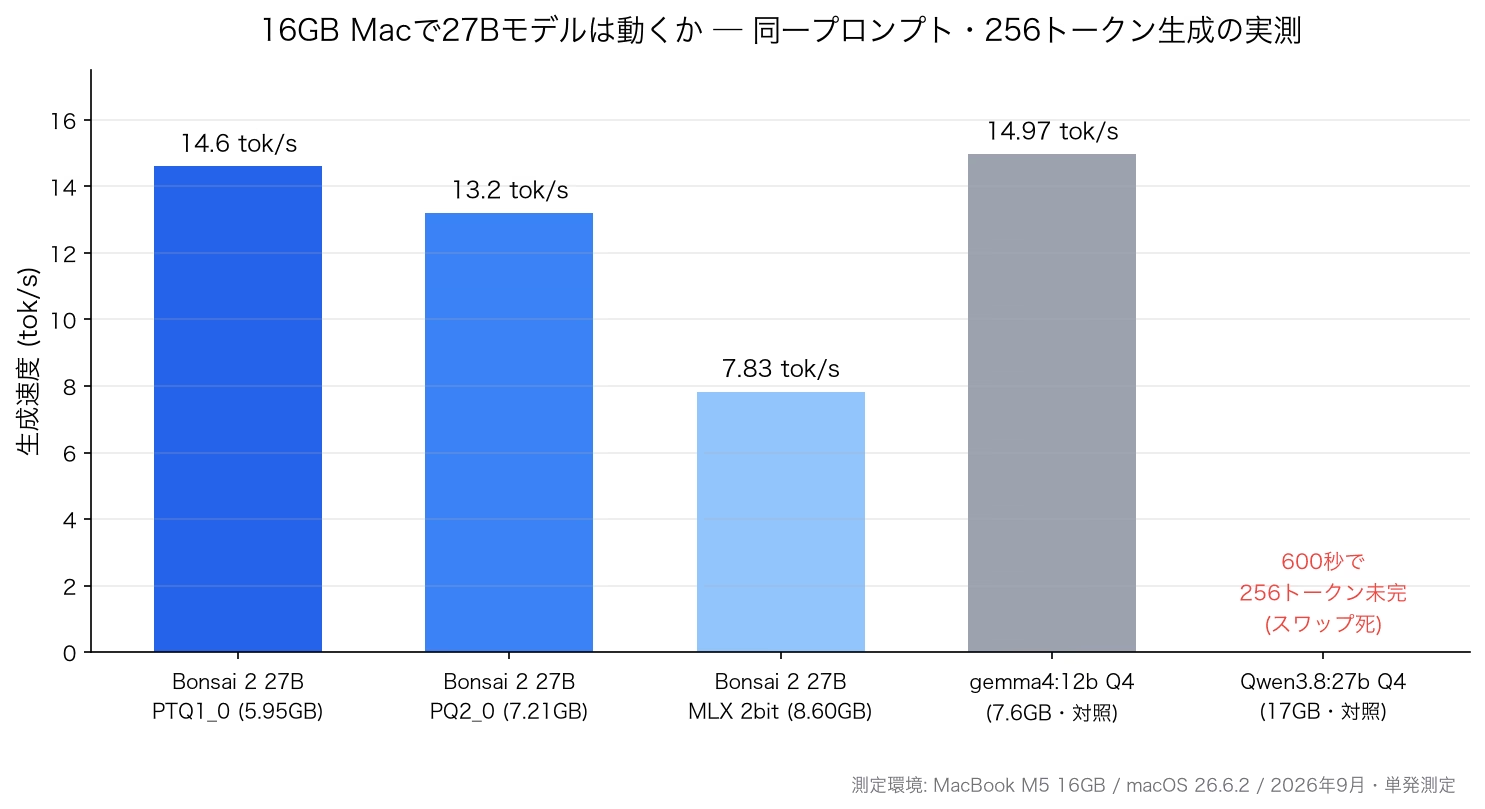
同一プロンプトで256トークンを生成したときの速度。右端のQ4は最後まで生成が終わりませんでした。
Q4の27Bは16GB Macでは物理的に動かない
まず「無理」を確かめた話から。OllamaでベースモデルのQwen3.8-27BをQ4で取得しました。サイズは17GB。RAMは16GBです。算数として既に負けていますが、スワップという逃げ道があるので、実際にどうなるか試しました。
ざっくりいうとスワップとは、RAMに足りなくなった分をSSDに退避させる仕組みです。SSDはRAMより遥かに遅いので、モデルの重みがスワップに置かれた瞬間、推論はSSDとの往復待ちになります。
結果をそのまま書きます。リクエストを投げてから600秒、256トークンの生成は終わりませんでした(12Bのgemma4なら17秒で終わる同じ設定です)。タイムアウト直後のスワップ使用量は7.99GB / 9.2GB。ファンが唸りっぱなしで、他の作業は諦めるしかない状態でした。
※「600秒で終わらない」以上の主張はしていません。生成は継続していた可能性があり、正確なtok/sは未計測です。
個人としては、これで「Q4ならまあ動くでしょ」という淡い期待は消えました。重み17GBを16GBに積む方法は、量子化を更に進める以外にない。
Bonsai 2は27Bを6GBまで潰している。なぜ動くのか
Bonsai 2 27Bは、2026年9月17日にPrismML(Caltechの研究を基盤に掲げる企業)が公開した三値量子化モデルです。ベースはQwen3.8-27B。20種のベンチマーク平均で、元のQwen3.8-27B(85.4)に対し83.9。公式はこれを「98.2%を維持」と表現しています。
三値量子化を平たくいうと、モデルの中身の「重み」を {-1, 0, +1} の三択だけに潰します。普通の量子化が「数値の精度を落とす」のに対し、Bonsaiは「数値をほぼ捨てる」。128個の重みごとにFP16のスケールを1つだけ残す設計で、27B級のモデルが5.95GB(PTQ1_0形式)まで縮みます。F16で配布されている元の重み(約54GB)の約9分の1です。
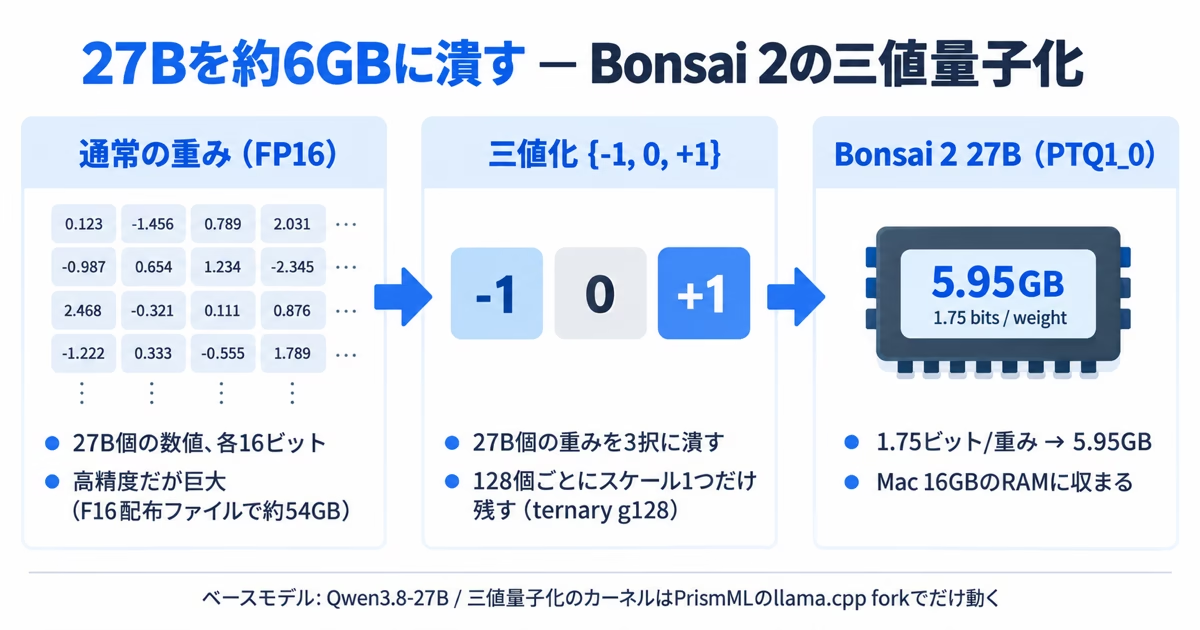
左から右へ、重みの持ち方が変わっていく流れです。
なぜ素朴な低ビット化でなく三値なのか。PrismMLの主張によれば、普通の2-bit量子化は「平均スコアは高いのに難問で崩壊する」ので、潰し方そのものを設計し直したとのことです(重みはApache 2.0で公開されていますが、レシピ自体は非公開。ここは主張として受け取るしかない部分です)。
注意が1つ。公称の「5.9GB」は、いちばん軽いPTQ1_0形式の話です。形式が重くなるとPQ2_0は7.21GB、MLX 2bitは8.60GB(画像入力用の部品を含む)まで増えます。
実は私も最初、ダウンロードツールが出す一覧を読み違えました。表示はGiB(1024進)で、PTQ1_0は「5.54」と出ます。これをGBと思い込み、「公称より小さい」と勘違いしていました。バイト数で確かめると5,946,648,928バイト、つまり5.95GBで、公称どおりです。容量の見積もりは単位まで確かめるのが安全です。
※2026年9月時点の情報です(Bonsai 2 27Bリリースから2日後の段階)。
形式を選ぶだけで速度が2倍変わる(実測3種)
Bonsai 2は同一モデルでも配布形式が3つあります。全部16GB Macで回してみました。同じプロンプト、256トークン生成、単発測定です。
| 形式 | 実ファイル | 生成速度 | prefill |
|---|---|---|---|
| GGUF PTQ1_0(1.75bpw) | 5.95GB | 14.6 tok/s | 77.1 t/s |
| GGUF PQ2_0(2.13bpw) | 7.21GB | 13.2 tok/s | 108.3 t/s |
| MLX 2bit(2.25bpw) | 8.60GB | 7.83 tok/s | — |
| Qwen3.8:27b Q4(対照) | 17GB | 600秒で256トークン未完 | — |
| gemma4:12b Q4(対照) | 7.6GB | 14.97 tok/s | 145 t/s |
読み方はシンプルで、軽い形式ほど速い。最重量のMLX 2bit(2.25ビット/重み)は7.83 tok/sまで落ちますが、最軽量のPTQ1_0なら14.6 tok/sと約2倍です。12Bのgemma4とほぼ同速度で、体感も「待たされる」レベルではありませんでした。
ただし、MLX 2bitだけは実行エンジンが別物です(GGUFの2つはllama.cpp fork、MLXはApple製のMLX)。約2倍の差のすべてがファイル形式によるものとは言い切れず、エンジンの差も混ざっています。
個人的にはここが一番の収穫でした。最初にMLX 2bitで試して7.83 tok/sを見たときは「Bonsai 2は遅いモデルなのか」と感じたのですが、実は最も重い形式が遅いだけで、形式を選べば12Bに追いつく。モデルの評価を1つの形式で切り上げると、こういう取り違えを起こすのだなと感じました。
速度と引き換えに精度は下がるはずなので、その観察が次の節です。
「アラン・チューリング」が3回とも間違った
精度の話をします。要約をお願いした文章には「チューリング」という名前が含まれています。正しくはアラン・チューリング。
3形式とも、この名前を間違えました。MLX 2bitは「アルフレッド・チューリング」。PTQ1_0は「アルジャン・チューリング」。PQ2_0も同じく「アルジャン」です。文章の構成そのものは崩れておらず、要約として筋が通っているのに、固有名詞だけが混ざる。エラーが出るわけではないので、気をつけて読まないと分からない種類の劣化でした。
PrismMLは「フル精度の98.2%を維持」と主張しています。この数字と固有名詞の混入ミスは矛盾しません。ベンチマークのスコアは保てていても、事実の名前は間違える——三値量子化の98.2%が何を保証し、何を保証しないかを、1つの観察として残しておく価値がありそうです。
動かすならllama.cpp forkだけ。stockツールは無言で壊れる
ここからは実際に動かす手順です。1つ重要な前提があります。
Bonsai 2は通常のllama.cpp・Ollama・LM Studioでは動きません。 三値の重みを読むカーネルがPrismMLのllama.cpp forkにしか存在しないためです。配布ページの自動生成パネルに ollama run のスニペットが表示されますが、そのまま実行しても動きません。
さらに1つ落とし穴がありました。MLX版を通常の mlx_lm.chat で読むと、エラーにならず誤った出力が返ってきます(重みにHadamard回転がかかっているため。同梱のruntimeを経由しないと変換がスキップされる)。公式docsには「stock MLXで動く」と書かれていましたが、この点はHugging Faceのモデルカードのほうが正しい。エラーではなく間違った答えが返る、というのが地味にいやらしい失敗です。
GGUF版を動かす手順はこの2ステップです。まず公式Releaseのprebuiltバイナリを取得します。
# PrismMLのllama.cpp forkからprebuiltバイナリ取得
bash scripts/download_binaries.sh

# GGUF取得(PTQ1_0が最小・最速)
bash scripts/fetch_gguf.sh prism-ml/Ternary-Bonsai-2-27B-gguf \
Ternary-Bonsai-2-27B-PTQ1_0.gguf続けて、ダウンロードしたGGUFをforkのllama-cliで起動します(-ngl 99で全層GPUへ、-fa onでFlashAttentionを有効化)。
./bin/mac/llama-cli -m models/Ternary-Bonsai-2-27B-gguf/Ternary-Bonsai-2-27B-PTQ1_0.gguf \
  -ngl 99 -fa on -c 8192 \
  --temp 1.0 --top-p 0.95 --top-k 20
生成速度から逆算すると、256トークンで約18秒です。16GB Macで27Bがこの速度で動くときは、率直にちょっと感動があります。
「最速」を競うInco Splashと「16GBでも動く」Bonsai 2は別の路線
同じ日に、Apple Silicon特化のOSS推論エンジン Inco Splash(Inco AI)も公開されました。Qwen3.8-27Bが144 tok/s(M5 Max)・Ollamaの最大3倍という主張で、これはこれで本物の速さを狙う路線です。
ただし要件を見ると、ユニファイドメモリ36GB以上。モデルパッケージは17.4GBで、16GB Macは最初から対象外です。試す前に要件で弾かれるので、今回は「動かない」の確認すら不要でした。
個人的には、Apple SiliconのローカルLLM最適化はここで二股に分かれたのだろうと見ています。36GB以上のマシンで最速を競う路線と、16GB機でも27Bに手を届かせる路線。どちらが正解ではなく、対象とするマシンのクラスが違うだけです。Bonsai 2の「潰し方を設計する」発想は、後者の路線でしか成立しない。メモリが増えても、この2つは別の道具であり続けるだろうと思います。
まとめ
要点の再掲です。
- 16GB Macで27BのQ4は物理的に不可能(重み17GB > RAM 16GB。実測で600秒256トークン未完・スワップ8GB)
- Bonsai 2 27Bなら5.95GB(PTQ1_0)で動く。形式を選べば 14.6 tok/s、12B denseと同速度
- ただし3形式とも「アラン・チューリング」を誤生成。98.2%維持の内側にある精度の代償は、使う側が知っておくべき
私の立場を明確にすると、PTQ1_0を使います。ただ、「16GB Macで本当に27Bクラスが必要なのか」という問いは依然として残ります。12Bで事足りる用途なら、12Bが正解です。Bonsai 2が実現したのは「16GBで27Bを選べるようになった」ということであって、「27Bが必要になった」ということではないという区別を意識しながら使いたいモデルでした。
コメント