「マイコンに日本語をしゃべらせたい。でも選べるのはロボット声だけ」
そう感じていたなら、状況は変わりました。0.65MBのニューラルTTSが、きちんと日本語を読み上げます。
ただし、半角の数字と英字は、エラーを出さずに消えます。
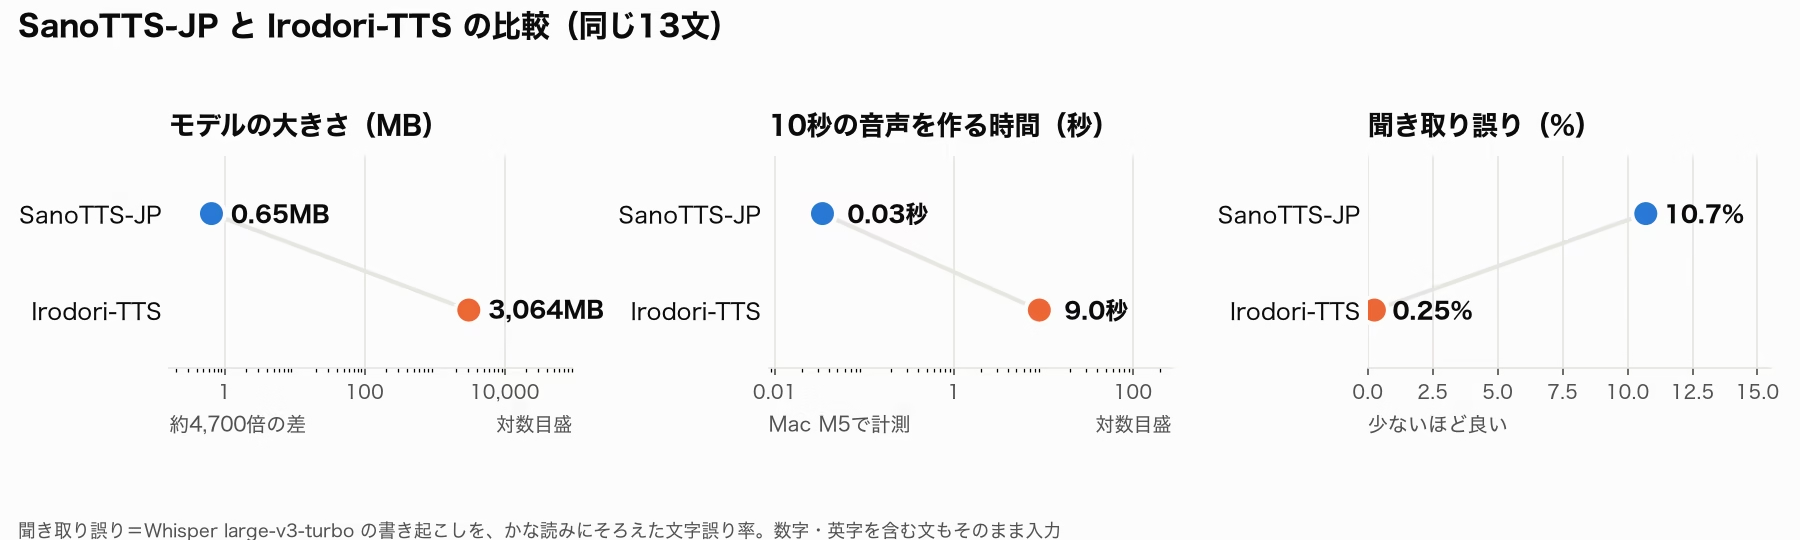
TL;DR: 同じ13文を0.65MBのSanoTTS-JPと3GBのIrodori-TTSで合成しました。SanoTTS-JPは約270倍速く、聞き取り誤りは10.7%(Irodoriは0.25%)。数字は全角にすれば読みます。
まず聴いてほしい。同じ文を2つのTTSで読ませた
説明より先に音を置きます。各項目とも、上がSanoTTS-JP、下がIrodori-TTSです。
ざっくりいうと、SanoTTS-JPは数百円クラスのマイコン(ESP32-S3)向けの日本語TTSです。Irodori-TTSは、私が毎朝のニュースPodcastで使っているPC向けのTTSです。どちらも私のMac(Apple M5)で合成し、音声認識のWhisperがどう聞き取ったかを添えました。
1. 短いあいさつ「今日は良い天気ですね。」
▶ SanoTTS-JP(0.65MB)
▶ Irodori-TTS(3GB)
Whisperの書き起こしは、どちらも正解でした。短く普通の文なら、SanoTTS-JPでも十分に聞き取れます。
2. 家電の通知「室温が二十八度を超えました。窓を開けるか、エアコンをつけてください。」
▶ SanoTTS-JP
▶ Irodori-TTS
SanoTTS-JPの「エアコン」は聞き取りにくかったです。Irodoriは全文正解です。
3. 同じ読みの言葉「橋の端で、箸を落としてしまった。」
▶ SanoTTS-JP
▶ Irodori-TTS
ここは耳で判断してください。Whisperは両方とも「橋の橋で橋」と書き起こしました。アクセントの違いは書き起こしでは測れません。開発者は、アクセントだけが違う語の組37組で全問正解と報告しています。
4. 感情のある文「やったー!ついに完成したよ!」
▶ SanoTTS-JP
▶ Irodori-TTS
SanoTTS-JPは「やった、ついに完成したよ」と聞き取られました。伸ばす音と感嘆が消えています。Irodoriは「やったー!」まで拾われました。
5. 日付「2026年9月11日、新しいバージョンが公開されました。」
▶ SanoTTS-JP
▶ Irodori-TTS
SanoTTS-JPの書き起こしは「年、月、日、新しいバージョンが…」でした。数字だけが抜けています。理由は後の節で書きます。
6. 英語の製品名「Claude Codeで、プログラムを自動生成します。」
▶ SanoTTS-JP
▶ Irodori-TTS
SanoTTS-JPは「け、黒クラムを自動生成します」。Claude Codeが丸ごと消えました。Irodoriは「クロードコード」と読んでいます。
7. 天気予報(3文・約11秒)
▶ SanoTTS-JP
▶ Irodori-TTS
少し長い文です。SanoTTS-JPは「午後から」が「ここから」になった以外、正解でした。
全13文を続けて聴ける版も置いておきます(2分23秒)。各文ともSanoTTS-JP、Irodori-TTSの順です。
大きさは約4,700倍、速さは約270倍違う
| SanoTTS-JP v1.0.0 | Irodori-TTS v4.1-Small | |
|---|---|---|
| パラメータ数 | 約56万 | 約7.7億 |
| モデルファイル | 0.65MB(漢字辞書13.7MBは別) | 3.06GB(音声コーデック約0.4GBは別) |
| 起動にかかる時間 | ほぼ0秒 | 約10秒 |
| 10秒の音声を作る時間 | 0.03秒 | 9.0秒 |
| 使ったメモリ | 18MB | 1.7GB |
| 聞き取り誤り(13文) | 10.7% | 0.25% |
| 自然さの予測スコア(UTMOS) | 1.37 | 3.24 |
| 話す速さ(1秒あたりのモーラ数) | 9.3 | 6.1 |
「10秒の音声を作る時間」は13文の合計から出しました。SanoTTS-JPは1スレッドのCPUだけ、IrodoriはMacのGPUを使っています。それでも約270倍の差でした。
前回の記事で、Irodoriの生成は音声の長さの2.5〜3倍かかると書きました。あれは1文ごとにモデルを読み込み直す構成での値です。モデルを1回だけ読み込めば、音声の長さとほぼ同じ時間で済みました。
聞き取り誤りは、Whisper large-v3-turboの書き起こしと元の文を、かな読みにそろえて比べた文字の誤り率です。Whisper自身の聞き違いも含みます。
UTMOSは英語で学習した「自然さ」の予測器で、日本語は低めに出ます。学習元の声(つくよみちゃん)の実際の録音でも2.31でした(開発者の計測)。差の大きさを見てください。
半角の数字と英字は、エラーを出さずに消える
今回いちばん大事な発見はこれでした。
「2026」だけを入れると、0.1秒の無音が返ってきます。「ABC」も同じで、エラーも警告も出ません。Whisperはこの無音を「ご視聴ありがとうございました」と書き起こしました。無音に対するWhisperのよくある幻聴です。
原因は開発者の設計記録にありました。辞書にない語は「誤読ではなく無音で脱落する」。例外も警告も出ない、と明記されています。
試すと、半角を全角に変えるだけで数字は読みました。
| 入力 | SanoTTS-JPの書き起こし |
|---|---|
2026年9月11日 | 「年、月、日」(数字が消える) |
2026年9月11日(全角) | 「2026年9月11日」(正しく読む) |
午後3時15分です。 | 「ココリッグネス」(崩れる) |
残り15パーセントです。(全角) | 「残り15%です」(正しく読む) |
ABCです。(全角) | 「DBCです」(読むが一部違う) |
クロードコード(カタカナ) | 「プロトコとて」(崩れる) |
全角にしたときの音声です。
▶ SanoTTS-JP(入力: 2026年9月11日、…)
マイコンに組み込むなら、入力の前に半角英数字を全角へ変える1行を入れておくと安全です。英語の製品名は、全角でもカタカナでも安定しませんでした。短い定型文なら、読みやすい言い換えを先に用意しておくほうが確実です。
聞き取りにくいのは、子音の出だしと語尾
数字と英字以外の聞き違いにも、共通点がありました。
- 語頭の母音が弱い: 「生憎の雨」が「飼い肉の雨」に。ひらがなで入れても同じで、発音の側の問題です
- 語が詰まる: 「丸の内一丁目」が「丸のちっちょ目」に。読点を入れて「丸の内、一丁目」にすると直りました
- 話す速さが速め: 1秒あたり約9.3モーラ(Irodoriは約6.1)。速さを変える設定はありません
一方で、13文のうち5文は、かな読みで完全に一致していました。
なぜ0.65MBまで小さくできるのか
SanoTTS-JPは「蒸留」という方法で作られています。大きなTTS(piper-plus)を先生にして、小さなモデルにその出力を真似させる方法です。
中身は3つの小さなモデルです。音の長さを決めるもの、音の特徴を作るもの、波形にするもの。合計で約56万パラメータしかありません。
重みも途中の計算も8ビットの整数です。ESP32-S3の整数の計算命令をそのまま使うためです。メモリは最初に確保した約160KBだけで計算し、途中で増やしません。マイコンでよくあるメモリ不足を、設計の段階で防いでいます。
漢字の読みは、Open JTalkの辞書を約44万語に削って載せています(13.7MB)。削った代わりに、辞書にない語は無音になる。数字が消える現象は、この小ささの裏返しなのだなと理解しました。
聴いてみると、そもそも比べるものではなかった
全部の音声を聴き終えて、これは基本的に比べるものではないな、と感じました。3GBと0.65MBです。勝ち負けを決める組み合わせではありません。
それでも、このサイズで日本語がちゃんと聞けるレベルにあるのは、素直にすごいと思いました。同時に、Irodori-TTSの日本語の質の高さも再認識できました。普段Podcastで毎朝聴いていると慣れてしまいますが、並べると差がはっきり分かります。
| 用途 | 向いているもの | 理由 |
|---|---|---|
| 毎朝のニュースPodcastのように、人が長く聴く音声 | Irodori-TTS | 聞き取り誤りが少なく、感情も乗る |
| スタックチャンやIoT機器の短い通知 | SanoTTS-JP | 0.65MB・約160KBのメモリで、ネットなしで動く |
| 英語の製品名が多い文 | どちらも注意 | Irodoriも英字は読みが揺れることがある |
人が長く聴く音声は、これからもIrodoriに任せます。一方で、小さなロボットに「室温が上がりました」と言わせる用途なら話は変わります。これまでマイコンで選べたのは、AquesTalkのような機械的な声でした。SanoTTS-JPを比べるべき相手は、Irodoriではなくそちらです。
試した環境と手順
- Mac: MacBook Pro / Apple M5 / メモリ16GB / macOS 26.6.2
- SanoTTS-JP: v1.0.0(2026年9月11日公開)/ 8ビット整数の重み / 漢字辞書438,750語版
- Irodori-TTS: v4.1-Small / MPS / 32ビット浮動小数点
- 評価: 13文×各1回。書き起こしはWhisper large-v3-turbo、自然さはUTMOS22
Irodoriは参照音声を使わず、声の特徴を文章で指定する機能(Voice Design)で合成しました。指定文は「明るく落ち着いた若い女性の声で、はっきりと自然に読み上げてください。」です。特定の人物の声ではありません。
SanoTTS-JPはESP32向けですが、ブラウザ版と同じC言語のコードをMac向けにビルドして動かしました。計算の中身はESP32で動くものと同じです。ESP32の実機では試していません。開発者の計測では、ESP32-S3で1秒の音声を約0.45秒で作れます。
詰まったのは1か所です。2文をまとめて入れたところ、「形態素44個まで」という理由で拒否されました。句点で文を分けて入れれば通ります。
いちばん手軽なのは、インストール不要のブラウザ版です。
- ブラウザ版: sanoTTS-jp デモ
手元で試すなら、リポジトリと重みを取得します。
git clone --depth 1 --branch v1.0.0 https://github.com/ayutaz/sanoTTS-jp.git
gh release download v1.0.0 -R ayutaz/sanoTTS-jp \
  -p 'saanotts-jp-v4-int8.bin' -p 'k1-dict-438750.bin'
ESP32-S3(16MB flash)なら、配布されているファームウェアを書き込むだけで漢字文を読みます。手順はリポジトリの docs/getting-started.md にあります。
まとめ
- 0.65MBでも日本語は読める。短い普通の文なら、書き起こしはほぼ正解
- ただし聞き取り誤りは10.7%で、Irodori(0.25%)とは差がある
- 半角の数字と英字は、エラーなしで無音になる。数字は全角にすれば読む
- 向いているのはマイコンやオフラインの短い通知。人が長く聴く音声はIrodoriのまま
2つは比べるものではありませんでした。ただ、並べて聴いたおかげで、0.65MBの健闘とIrodoriの質の高さを両方とも実感できました。マイコンでもニューラルな声で日本語が出る段階には、すでに来ています。まずはブラウザ版で、読ませたい文を実際に入力して試してみてください。
関連記事
– Irodori-TTSの自分専用ニュースを61日間毎日車で聞いた
音声のクレジット: SanoTTS-JPの音声は、フリー素材キャラクター「つくよみちゃん」(© 夢前黎)の音声データを学習元に含むモデルで合成しました。本記事の音声の二次利用(素材としての利用)はご遠慮ください。
- SanoTTS-JP: ayutaz/sanoTTS-jp(コードはMIT、重みは独自ライセンス)
- Irodori-TTS: Aratako/Irodori-TTS-v4.1-Small(MIT)
- つくよみちゃんコーパス: つくよみちゃん公式サイト
コメント