この記事は「ローカルLLM完全ガイド」の一部です。
「Hugging Faceを開いたら、同じモデルにQ8_0、Q6_K、Q4_K_M、IQ3_XXS……と十数個のファイルが並んでいた。どれを落とせばいいのか」
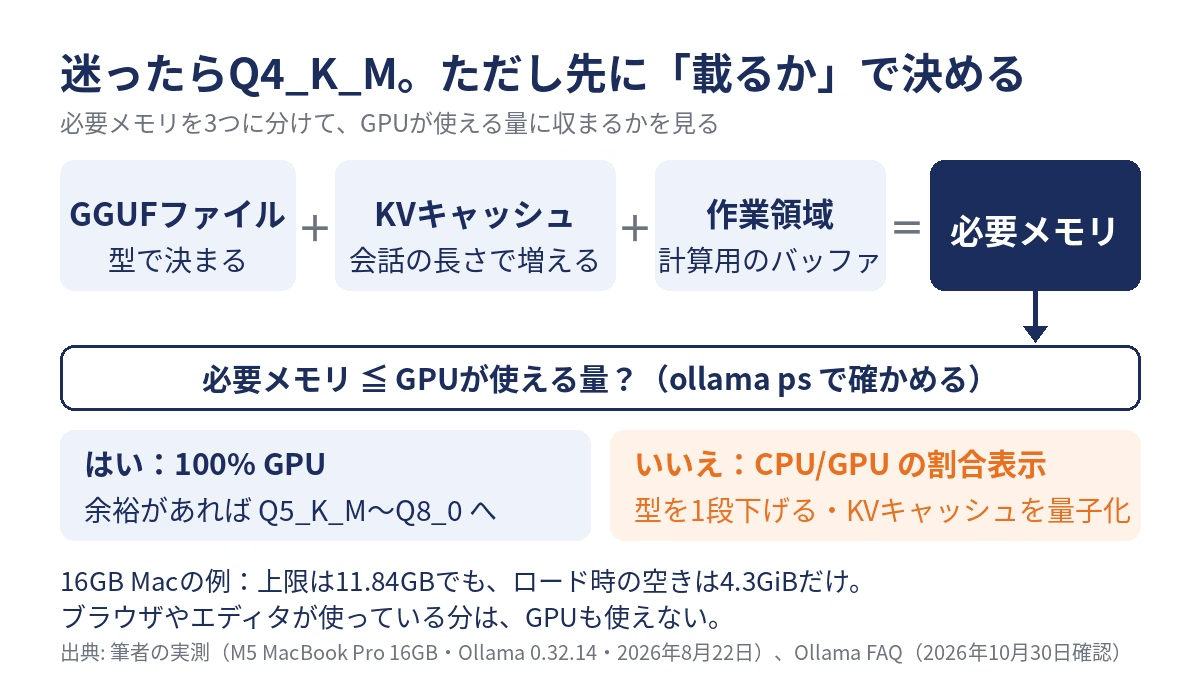
迷ったらQ4_K_Mを選び、メモリに余裕があればQ5_K_M〜Q8_0に上げる。ただしモデル+会話(KVキャッシュ)がGPUに載る量を超えると速度が桁で落ちるので、「品質」より先に「載るか」で決める。
私は16GBのMacで、この速度の崖を踏みました。ファイルが1.1GB大きいだけで、文章の生成が約20倍遅くなったのです。
結論(30秒)
- 迷ったら Q4_K_M。メモリに余裕があれば Q5_K_M〜Q8_0 に上げる。ただし「品質」より先に「載るか」で決める
- 8BモデルならQ4_K_Mは約4.9GB、Q8_0は約8.5GB(ollama.comのタグ表示、2026年10月30日確認)
- 必要なメモリはファイルの大きさに会話の分(KVキャッシュ)と作業領域を足した量です
- 私のM5 MacBook Pro 16GBでは、GPUが使える上限は11.84GB。はみ出しが増えると、生成は0.22 tok/sまで落ちました(2026年8月22日の私の実測)
- 載ったかどうかは
ollama psのPROCESSOR列で分かります。100% GPUでなければ、型を1段下げます
※製造業の社内IT担当として、手元のMacでローカルLLMを試してきた立場から書いています。速度の数値は2026年8月22日の私の実測で、今回あらためて測り直してはいません。
量子化の名前は、数字・K/IQ・S/M/Lの3か所だけ読めばいい
GGUFの量子化は、重みを16bitから8〜2bitに縮めてファイルと必要メモリを減らす方法。名前の数字がビット数の目安、KはK-quant、IQは重要度行列(imatrix)を使う方式、末尾のS/M/Lはサイズの大小。
Q4_K_M なら「4bit前後・K-quant・中くらい」。IQ3_XXS なら「3bit前後・重要度行列を使う方式・いちばん小さい」。読み方はこれで足ります。
ざっくりいうと、縮めるほどファイルは軽くなり、元のモデルとの差は開きます。llama.cppのREADMEは、この差をperplexity(次の単語をどれだけ迷うか)やKLD(元のモデルの出力分布とのずれ)で測ると説明しています。下がり方は重要度行列(imatrix)で抑えられる、とも書かれています。
では実際の大きさはどうか。llama.cppのREADMEにあるLlama-3.1-8Bの表と、Ollamaの公式ライブラリのタグ表示を並べました。
| 型 | bits/weight | 8Bのファイル(README) | 8Bのファイル(Ollamaタグ) | 品質の目安(定性) | 向く人 |
|---|---|---|---|---|---|
| F16 | 16.0005 | 14.96 GiB | 16GB(fp16) | 元のまま | 自分で量子化する人の元ファイル |
| Q8_0 | 8.5008 | 7.95 GiB | 8.5GB | 元に近い | メモリに余裕がある人・比べる基準が欲しい人 |
| Q6_K | 6.5633 | 6.14 GiB | 6.6GB | Q8_0 と Q4_K_M の間 | Q8_0 が載らない人 |
| Q5_K_M | 5.7036 | 5.33 GiB | 5.7GB | Q8_0 と Q4_K_M の間 | 少しだけ余裕がある人 |
| Q4_K_M | 4.8944 | 4.58 GiB | 4.9GB | 標準的な落としどころ | 迷った人 |
| IQ4_XS | 4.4597 | 4.17 GiB | — | Q4_K_M と Q3_K_M の間(推定) | Q4_K_M があと少し載らない人 |
| Q3_K_M | 3.9960 | 3.74 GiB | 4.0GB | 下がる | 大きいモデルを無理に載せる人 |
| IQ3_XXS | 3.2548 | 3.04 GiB | — | 下がる | 同上 |
| Q2_K | 3.1593 | 2.95 GiB | 3.2GB | さらに下がる | 速度の崖を避けたい最後の手段 |
| IQ2_XXS | 2.3824 | 2.23 GiB | — | さらに下がる | 同上 |
出典: llama.cpp tools/quantize README(Llama-3.1-8B)、ollama.com/library/llama3.1/tags(llama3.1の8b-instruct各タグ)。いずれも2026年10月30日確認。「—」はOllamaのタグに無い型。品質の列はREADMEの説明をもとにした定性的な並びで、数値ではありません。
2つの「8Bのファイル」の列は食い違って見えますが、READMEはGiB、OllamaはGBで書いているだけです。4.58GiBは約4.92GBで、他の行も換算すると合います。Hugging FaceのドキュメントではQ4_Kが4.5 bitと、READMEのQ4_K_M(4.8944)より小さめです。ドキュメントの値は1ブロックあたりの理論値で、実ファイルは層ごとに型を混ぜているためだと推定しています。
READMEの別の表では、Llama 3.1 8Bが32.1GBから4.9GBに、70Bが280.9GBから43.1GBになっています。量子化しなければ、手元のマシンにはまず載りません。
品質の差より先に、「載るか」の差が桁で効く
表を見ると「メモリが許す限りビット数を上げればいい」と考えたくなります。その考えは8月22日の測定で崩れました。
2026年8月22日、M5 MacBook Pro 16GBで27Bのモデルを2種類の量子化で動かしました。Ollama 0.32.14、コンテキスト長(num_ctx)8192、KVキャッシュはq8_0、Chromeとエディタは開いたままの普段の作業状態です。
| 量子化 | ファイル | CPU / GPU の分担 | 生成速度(decode) |
|---|---|---|---|
| UD-IQ3_XXS(3bit) | 10.93GB | 19% / 81% | 0.22 tok/s |
| UD-Q2_K_XL(2bit) | 9.83GB | 11% / 89% | 2.47〜4.52 tok/s |
出典: 筆者の実測(M5 MacBook Pro 16GB、Ollama 0.32.14、2026年8月22日)。詳細は「Qwen3.8 27Bは16GB Macで動く、2bitなら」。
3bit側は167トークンを出すのに12分かかりました。1文字ずつ待つ速さです。ファイルを1.1GB小さくした2bit側では、生成が最大で約20倍速くなりました。
勘違いしやすいのは、2bit側も11%がCPU側にこぼれていたことです。載る・載らないの二択ではありません。手元で見たのは、はみ出す量が増えるほど、どこかで速度が崖のように落ちるという形でした。
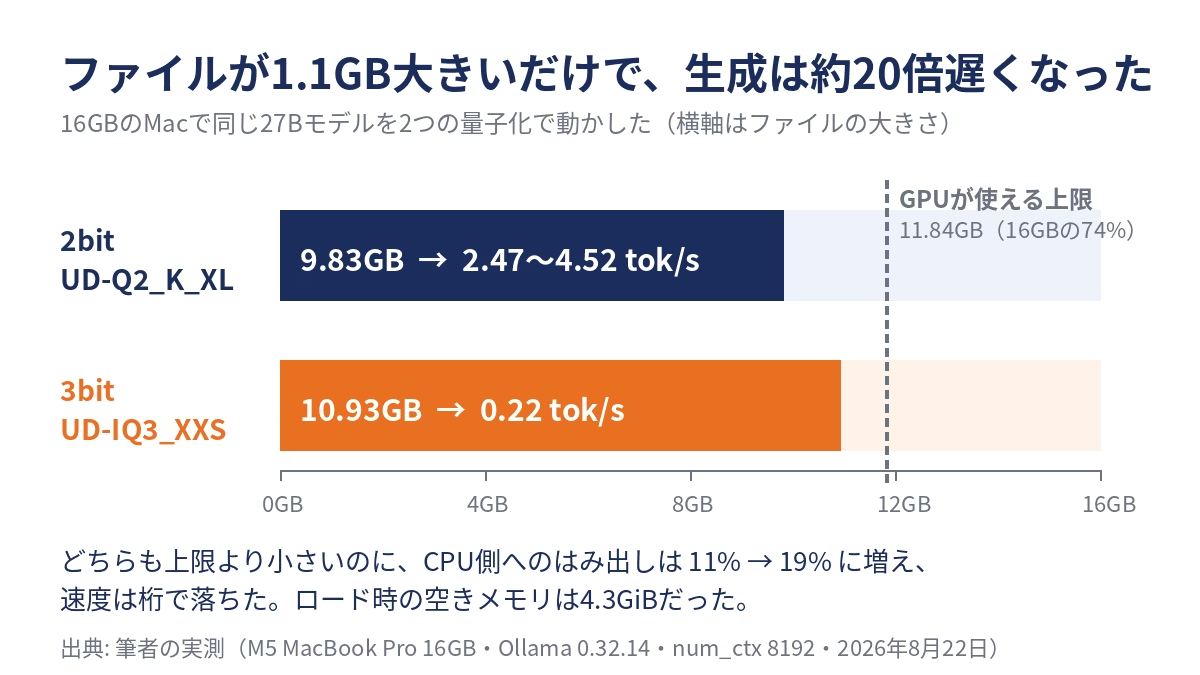
品質は、ビット数を下げるほど元との差が開いていきます。一方の速度は、載り方ひとつで桁が変わります。だから順番を逆にして、先に「載るか」を見ます。
16GBあっても、GPUが使えるのは11.84GBで、実際はもっと少ない
なぜ9.83GBが16GBのMacに収まらなかったのか。私は最初、macOSがGPUに割ける上限が低いせいだと誤解していました。
Metal(MacのGPUの仕組み)が申告する上限 recommendedMaxWorkingSetSize は11.84GBで、物理メモリ16GBの74.0%でした。これなら入りそうに見えます。
ところがOllamaのロード時のログには、system memory free="4.3 GiB" と出ていました。MacはメモリをCPUとGPUで共有しています。ブラウザやエディタが使っている分は、GPUも使えません。結果として66層のうち61層だけがGPUに載り、残りがCPUに回りました。
必要なメモリはざっと次のように分けて考えます。
必要メモリ ≒ GGUFファイル+KVキャッシュ(会話の長さに比例)+作業領域。ファイルが収まっても長い会話で溢れることがある。
KVキャッシュは、それまでの会話をモデルが覚えておく領域で、会話を伸ばすほど大きくなります。8月22日のモデルは構造の都合でKVキャッシュが小さく、効いていたのは重みのほうでした。どちらが効くかはモデルで変わります。
手元のメモリで、型を1つに絞る
ここまでを判断表にまとめます。行は手元のメモリ、列は使い道です。
| 手元のメモリ | まず試す | 日本語の文書(要約・社内Q&A) | コード |
|---|---|---|---|
| 8GB | 8B の Q4_K_M(推定。ファイルだけで半分を超えるので、ブラウザを閉じて短い会話から) | 同左。溢れるなら小さいモデルの Q4_K_M(推定) | 同左(推定) |
| 16GB Mac | 8B の Q4_K_M | 8B〜12B の Q4_K_M〜Q5_K_M(推定) | 14B級は境目付近(GGUF Q4_K_Mのqwen3:14bは約9.3GB。Ollamaでは未測定・推定)。参考にMLX 4bit版はピーク8.42GB・14.69 tok/s(2026年4月の実測)。27Bは2bitでも11%溢れた(8月22日の実測) |
| 24GB | 8B の Q8_0(推定) | 12B〜14B級の Q5_K_M〜Q6_K(推定) | 同左。長いコンテキストを使うなら1段下げる(推定) |
| 32GB以上 | 8B の Q8_0(推定) | 大きいモデルは Q4_K_M から試す(推定) | 70B の Q4_K_M はファイルだけで43GB。32GBには載らない |
前提: 16GB Macの行の27Bの数字は2026年8月22日の筆者実測(M5 MacBook Pro 16GB、Ollama 0.32.14、num_ctx 8192)。14BのMLXの数字は、2026年4月に同じMacでmlx_lmを使い mlx-community/Qwen3-14B-4bit を測った筆者実測で、GGUFではありません(測定の記事)。サイズはllama.cpp READMEとollama.comのタグ表示(qwen3:14bを含む、2026年10月30日確認)。「推定」はファイルサイズからの見積もりで、測っていません。
この表で意味があるのは、16GB Macの行の右端です。ファイルが10GB前後になると、16GBのMacは「動くけれど待てない」側に入ります。逆に8Bなら、Q4_K_MとQ8_0のどちらでもファイルは11.84GBの上限を下回ります。品質で悩む余地があるのは、こういうときだけです。
24GB以上の行には注意がひとつあります。Ollamaの既定のコンテキスト長は、GPUのメモリが24GiB未満なら4k、24〜48GiBなら32k、48GiB以上なら256kです。メモリの大きいマシンほど、何も設定しなくてもKVキャッシュが大きく取られます。
「載ったか」はollama psの1列で分かる
型を決めたら、実際に載ったかを確かめます。次のコマンドは、動かしているモデルのうちどれだけがGPUに載っているかを表示します。
ollama ps
8月22日に私の手元で出た表示はこうでした。
NAME                                      SIZE   PROCESSOR          CONTEXT
...Qwen3.8-27B-GGUF:UD-IQ3_XXS            11 GB  19%/81% CPU/GPU    8192
...Qwen3.8-27B-GGUF:UD-Q2_K_XL            10 GB  11%/89% CPU/GPU    8192
PROCESSOR列が 100% GPU なら全部載っています。19%/81% CPU/GPU のように割合が出たら、その分がCPU側にこぼれています。OllamaのFAQにも同じ読み方が載っています。
次に、落としたモデルが何bitかを確かめます。OllamaのAPI /api/show を呼ぶと、details.quantization_level に Q4_K_M のような値が入っています。
curl -s http://localhost:11434/api/show -d '{"model": "llama3.1:8b"}' | grep -o '"quantization_level":"[^"]*"'
型を指定して落とすには、タグに量子化名を付けます。Ollamaのライブラリなら、量子化はタグ名の末尾に入っています。
# Ollama ライブラリ:タグ名で指定(llama3.1:8b は q4_K_M と同じもの)
ollama run llama3.1:8b-instruct-q8_0

# Hugging Face のリポジトリ::量子化名 で指定(大文字小文字は区別しない)
ollama run hf.co/{user}/{repo}:Q8_0
hf.co/{user}/{repo} だけで呼ぶと、リポジトリにQ4_K_Mがあればそれが選ばれます(Hugging Faceのドキュメント)。llama3.1:8b も、ollama.comで見ると 8b-instruct-q4_K_M とdigestまで同じでした。このモデルでは何も指定しなければQ4_K_Mです。全モデルがそうだとは限りません。
私が踏んだ罠もひとつ書いておきます。Hugging Faceのリポジトリによっては、量子化名の前に UD- のような接頭辞が付いています。8月22日に UD- を付け忘れたら、ダウンロードが100%まで進んだあとに Error: file does not exist で止まりました。しかも終了コードは0です。スクリプトで回すなら、落としたあと ollama list に出ているかを見てください。
※本節の curl と ollama run のタグ指定は公式ドキュメントの書式に沿ったもので、今回は実行していません(2026年10月時点)。ollama ps の表示と UD- の罠は2026年8月22日の私の手元のものです。
GGUFを落としてModelfileで取り込む手順は以前の記事に書きましたが、これは古い手順です。今は上の hf.co/... の形で直接取れます。
溢れやすいのは、長い会話・取り込み・再量子化の3か所
判断表どおりに選んでも、あとから溢れることがあります。よくあるのは次の3つです。
1. コンテキストを伸ばすと、KVキャッシュで溢れる。 Ollamaのドキュメントは、コンテキスト長を大きくすると必要なメモリが増えると書く一方で、エージェントやコーディングには64000以上を勧めています。16GBのMacでQ4_K_Mが収まっていても、64000に上げた途端にPROCESSOR列が割合表示に変わることはありえます(推定)。対策は型を1段下げるか、KVキャッシュも量子化するかです。OLLAMA_KV_CACHE_TYPE=q8_0 でf16の約1/2、q4_0 で約1/4になります(Flash Attentionが有効なとき。既定はf16)。
2. OllamaはGGUFを取り込むときに量子化しない。 16bitのGGUFは16bitのまま入ります。公式の手順はllama.cppの llama-quantize で先に量子化しておく流れです。「取り込めば軽くなる」と思っていると、ファイルの大きさで詰まります。
3. 量子化済みのファイルを、さらに量子化しない。 llama.cppの llama-quantize には --allow-requantize というオプションがあります。READMEはこれについて、16bitや32bitから量子化するより品質が大きく落ちうると警告しています。Q8_0をQ4_K_Mに落としたくなったら、元の16bitから作り直してください。配布元にQ4_K_Mがあるなら、そちらを落とすほうが早いです。
落とす前に確かめる6項目
自分の環境に置き換えるためのチェックリストです。
- [ ] 手元のメモリのうち、GPUが使えるのはどれくらいか(私のM5 MacBook Pro 16GBでは11.84GBだった)
- [ ] その上限からブラウザやエディタの分を引いたか(8月22日は空きが4.3GiBしかなかった)
- [ ] 使うコンテキスト長はいくつか(既定のままか、コーディング用に伸ばすか)
- [ ] 落としたモデルの量子化を
/api/showのquantization_levelで確かめたか - [ ]
ollama psのPROCESSOR列が100% GPUになっているか - [ ] 自分で量子化するなら、元の16bitから
llama-quantizeで作っているか
よくある質問
Q1. Q4_K_MとQ8_0の違いは?
8Bで比べると、Q4_K_Mは約4.9GB、Q8_0は約8.5GBです(ollama.comのタグ表示、2026年10月30日確認)。Q8_0は元のモデルに近く、Q4_K_Mはそれより差が開きます。差を%で示せる一次情報は無かったので書きません。余裕があればQ8_0、なければQ4_K_Mが目安です。
Q2. Ollamaでダウンロードしたモデルは何bit?指定するには?
llama3.1:8b の既定タグはQ4_K_Mでした(このモデルで確認)。確かめるのは /api/show の details.quantization_level、指定はタグ名(llama3.1:8b-instruct-q8_0)か hf.co/{user}/{repo}:Q8_0 です。
Q3. 16GBのMacで27B〜30B級は動く?2〜3bitにする価値は?
動きはします。ただ8月22日の私の実測では、27Bの3bit(10.93GB)は0.22 tok/s、2bit(9.83GB)でも2.47〜4.52 tok/sで、11%はCPUにこぼれていました。対話のテンポで使うなら、16GBでは14B級が境目です。GGUFのqwen3:14b(Q4_K_M)は約9.3GBで、8月22日に溢れた9.83GBに近く、Ollamaでは測っていません(推定)。MLX 4bit版なら8.42GB・14.69 tok/sで動きました(2026年4月の実測)。27Bの数字の詳細は実測の記事にあります。
Q4. IQ系とK系はどちらを選ぶ?
IQ系は重要度行列(imatrix)で下がり方を抑える方式です。READMEの表では、IQ4_XSは4.17GiBでQ4_K_Mより少し小さい型です。Q4_K_Mがあと少しで載らないときに試すのが、素直な使い方です。生成速度はREADMEの表(Llama-3.1-8B、128トークン生成。測定機材の記載なし)でIQ4_XSが77.51 t/s、Q4_K_Mが71.93 t/sで、大きな差はありません。Macでの差は測っていません。
迷ったらQ4_K_M、その前にollama ps
16GBのMacで最初に落とすなら、8B〜12B級のQ4_K_Mです。ollama ps で載ったのを確かめてから、余裕があればQ5_K_MやQ8_0に上げます。品質から選ぶと順番が逆になります。8月22日の1.1GBの差はその逆の順番で選んだ代償でした。
残っている問いもあります。同じ8BモデルのQ4_K_MとQ8_0を16GBのMacで並べたときの速度は、まだ測っていません。
関連記事
- Qwen3.8 27Bは16GB Macで動く、2bitなら — 1.1GBの差で20倍変わった実測の全体
- 日本語ローカルLLMの選び方:16GB Macは速さで選ばない — どのモデルを選ぶか
- Hugging FaceのGGUFファイルをOllamaで動かす方法 — Modelfileで取り込む古い手順
- ハブ: ローカルLLM完全ガイド
参考・確認日
- llama.cpp tools/quantize README(2026年10月30日確認)
- Hugging Face Hub: GGUF(2026年10月30日確認)
- Hugging Face Hub: Ollama(2026年10月30日確認)
- ollama.com/library/llama3.1/tags(2026年10月30日確認)
- ollama.com/library/qwen3/tags(2026年10月30日確認)
- Apple M5でOllamaが落ちる、mlx_lmへの逃げ方(筆者・2026年4月27日公開、14B の MLX 実測)
- Ollama docs: Import(2026年10月30日確認)
- Ollama: FAQ(2026年10月30日確認)
- Ollama docs: Context length(2026年10月30日確認)
- Ollama API: Show model details(/api/show)(2026年10月30日確認)
更新履歴: 2026-10-30初版
コメント