この記事は「ローカルLLM完全ガイド」の一部です。
「会議の録音を外に出さずに文字起こししたい。でも、どのモデルを入れればいいの?」
日本語の文字起こしをローカルでするなら、MacではWhisper large-v3-turboを基準にし、NVIDIA GPUのPCで日本語だけを大量に回すならparakeet-tdt_ctc-0.6b-jaを候補に加え、最後は自分の会議録音10分で文字誤り率と処理時間を比べて決める。
ただし、どれが一番正確かは、あなたの会議録音ではまだ誰も測っていません。
結論(30秒)
- MacならWhisper large-v3-turbo(whisper.cpp)を基準にし、NVIDIA GPUのPCで日本語だけを大量に回すならparakeet-tdt_ctc-0.6b-jaも候補にして、最後は自分の会議録音10分で決めます。
- 以前の記事で測ったとき、合成音声ではturboとlarge-v3の誤り率はほぼ同じで、turboのほうがずっと速く、8GBのM2でも動きました。
- 8GBのMacでリアルタイム字幕まで求めるのは苦しく、小さいモデルに替えるか、会議の後にまとめて処理します。
- 費用だけならAPIが安く、月20時間の会議で約567〜1,134円(推定)。ローカルを選ぶ理由は、録音を外に出せないことです。
※製造業の社内IT担当として、会議の録音をどこまで外に出してよいかを相談される立場から書いています。「以前の記事で測った」数字は私の公開済み記事の実測で、今回新しくは測っていません。
選ぶものは、手元の機材と用途の掛け算で1つに決まります
「一番精度の高いモデル」を探すと、順位表を何本も読むことになります。けれども測った音声と機材が自分と違えば、順位は当てはまりません。先に決めるのは、手元の機材と用途です。
行が機材、列が用途で、セルには1つだけ書きました。
| 手元の機材 | 会議の後に議事録 | リアルタイム字幕 | 英語混じりの動画・会議 |
|---|---|---|---|
| 8GBのMac | Whisper large-v3-turbo(whisper.cpp) | ReazonSpeech k2 v2(sherpa-onnx) | Whisper large-v3-turbo(whisper.cpp) |
| 16GBのMac | Whisper large-v3-turbo(whisper.cpp) | Whisper large-v3-turbo(whisper.cpp) | Whisper large-v3-turbo(whisper.cpp) |
| NVIDIA GPUのPC | parakeet-tdt_ctc-0.6b-ja(NeMo) | Whisper large-v3-turbo(faster-whisper) | Whisper large-v3(faster-whisper) |
根拠: Macの2行は、以前の記事で測ったturbo/large-v3の推論時間(M2 8GB・M5 16GB、合成音声)とWhisperのREADMEのVRAM目安(large 約10GB、turbo 約6GB)。GPU PCの行とReazonSpeech・Parakeetのセルは公式情報(2026年11月4日確認)からの推奨で、速度と精度は未測定。会議音声での誤り率は、どのセルも未測定です。
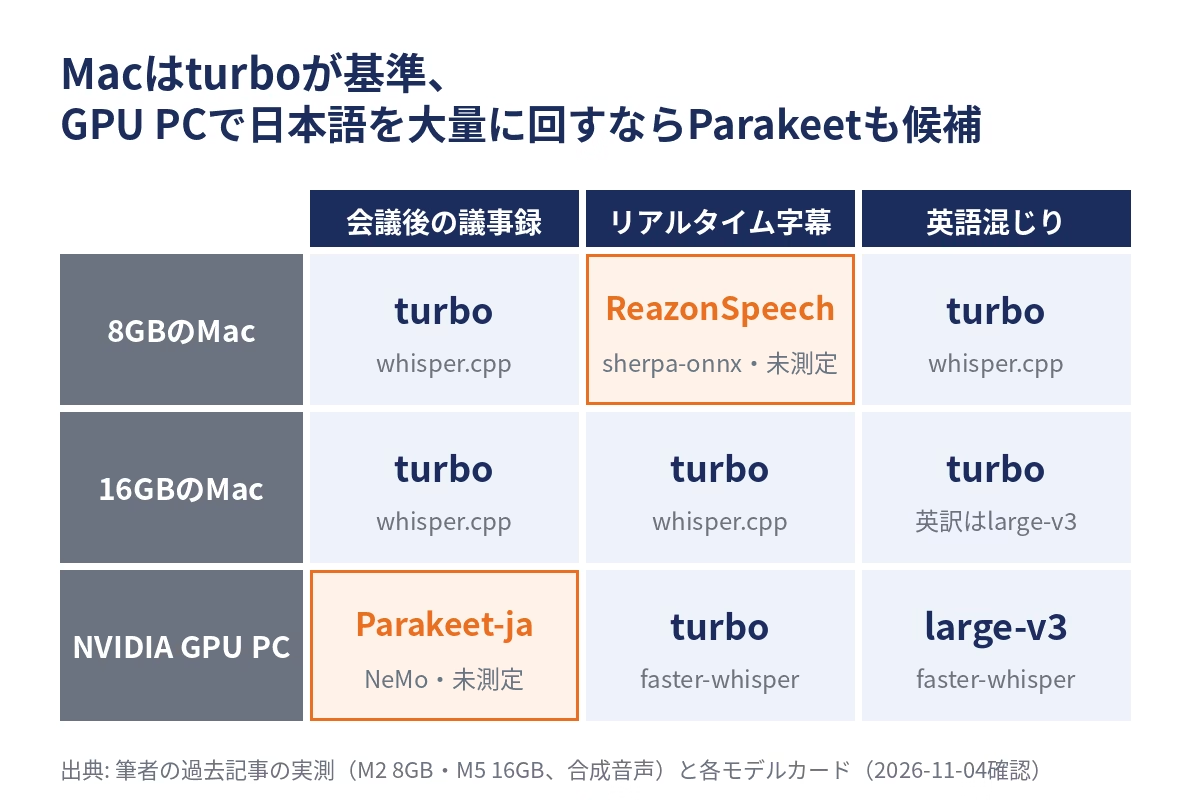
Macの欄がほぼturboで埋まったのは、私の手元の数字がturboを指しているからです。
GPU PCの行だけ、答えが割れます。議事録は話し言葉で学習したParakeet、字幕は以前速さを確かめたfaster-whisperに軽いturboを載せたもの、英語混じりは英訳もできるlarge-v3です。
私の数字はturboを指していました
この節の要点: 以前の記事で、合成音声10本をMacで書き起こしたとき、turboとlarge-v3の誤り率はほぼ同じで、turboは数倍速かった。8GBのM2でもturboは動いた。ただし会議音声ではない。
土台は4月に書いた2本の記事です。TTS(音声合成)で作った日本語の音声10本を、Whisperに書き起こさせました。短い1〜3秒が5本、7〜9秒が3本、16〜18秒が2本で、合計約67秒です。MLXで動かし、8GBのMacBook Air M2と、16GBのMacBook Pro M5で測っています。
| モデル | CER(文字誤り率) | 平均推論時間 M2 8GB | 平均推論時間 M5 16GB |
|---|---|---|---|
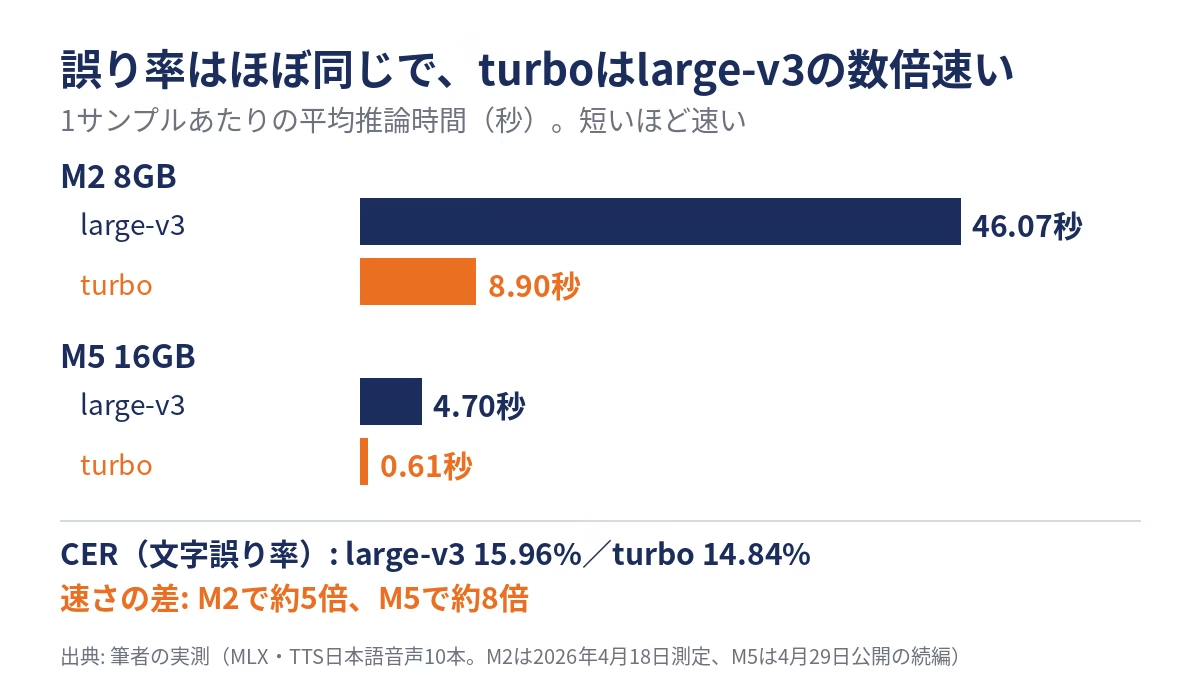
| Whisper large-v3 | 15.96% | 46.07秒 | 4.70秒 |
| Whisper large-v3-turbo | 14.84% | 8.90秒 | 0.61秒 |
1サンプルあたりの平均です。音声は合成で、雑音も訛りも入っていません(M2は2026年4月18日測定、M5は4月29日公開の続編)。
測る前は、large-v3のほうが正確だと思っていました。turboはlarge-v3を軽くした版で、READMEも「精度の低下は小さい」と書いています。小さくても、下がるはずでした。
実物は逆でした。誤り率は14.84%と15.96%で、ほぼ同じ。turboのほうがわずかに低いくらいです。一方で速さは、M2で約5倍、M5で約8倍の差がつきました。
同じ誤り率なら、速いほうを選ばない理由がありません。
8GBのM2でも、turboは動きました。ただ平均8.90秒は、サンプルの平均の長さ(約7秒)より長い。字幕を出すと音声に追いつかない計算です(推定)。8GBのMacの字幕の欄だけturboを外したのは、このためです。
M5の16GBなら0.61秒で、音声の長さを大きく下回ります(推定。字幕として連続で動かしたことはありません)。
この2本は、もともとGemma 4の音声入力とWhisperを比べた記事です。Gemma 4を含めた表と測り方は、元の記事にあります。
候補の5モデルは、日本語だけか多言語かで二手に分かれます
では、turboと比べる候補には何を入れるか。よく名前が挙がる5つと、参考にAPIを並べました。
| モデル | パラメータ | 動かす道具 | Macで動くか | 対応言語 | 英語混じり | ライセンス | 録音が外に出るか |
|---|---|---|---|---|---|---|---|
| Whisper large-v3 | 約1,550M | whisper.cpp/faster-whisper/MLX | 動く(M2 8GB・M5 16GBで以前測定) | 多言語(99) | 可。英訳も可 | MIT(GitHub)※ | 出ない |
| Whisper large-v3-turbo | 約809M | whisper.cpp/faster-whisper/MLX | 動く(同上) | 多言語 | 書き起こしは可。英訳は学習されていない | MIT | 出ない |
| Kotoba-Whisper v2.0 | 約756M | Transformers/faster-whisper用・whisper.cpp用の重みあり | whisper.cpp用の重みで動かせる(未測定) | 日本語 | 日本語向けに蒸留(英語部分は未測定) | Apache-2.0 | 出ない |
| parakeet-tdt_ctc-0.6b-ja | 約0.6B | NVIDIA NeMo/sherpa-onnx(ONNX変換版) | sherpa-onnxでCPU実行(未測定) | 日本語(句読点つきで出力) | 日本語専用 | CC-BY-4.0(表示すれば商用可) | 出ない |
| ReazonSpeech k2 v2 | 159.34M | sherpa-onnx | sherpa-onnxでCPU実行(未測定) | 日本語 | 日本語専用 | Apache-2.0 | 出ない |
| 参考:OpenAI API(gpt-transcribeほか) | 非公開 | API | 機材を問わない | 多言語 | 可 | 利用規約による | 出る |
出典: 各モデルカード(Hugging Face)、OpenAI Whisper・whisper.cpp・faster-whisper・sherpa-onnx の GitHub、OpenAI の料金ページ。すべて2026年11月4日確認。※Whisper large-v3 は GitHub のリポジトリがコードと重みを MIT としている一方、Hugging Face のモデルカードの表記は apache-2.0 です。
この表で見てほしいのは、「対応言語」と「英語混じり」の2列です。
下の3つは日本語の専用機です。英語で話す時間が長い会議や動画は、上の2つのWhisperに任せます。日本語専用モデルが英語部分をどう書くかは、試していません。
逆に、日本語だけの録音を大量に回すなら下の3つが効きます。候補に残した理由は1つずつ違います。
Kotoba-Whisper v2.0は、large-v3を日本語向けに蒸留したモデルです。モデルカードは「large-v3より6.3倍速く、誤り率は同程度」と主張しています(未測定)。whisper.cpp用の重みがあるので、Macでturboと同じ道具のまま入れ替えて比べられる。日本語の会議だけなら、turboの次に試す1本です。
parakeet-tdt_ctc-0.6b-jaは、NVIDIAのNeMoで動く日本語専用モデルです。学習したのはReazonSpeech v2.0、35,000時間を超える自然な日本語の音声です。読み上げではなく、話し言葉で学んでいる。議事録の欄に置いたのはこの点と、句読点つきで出てくる点です。句読点がないと、議事録に整える手間が一段増えます。モデルカード自身の文字誤り率(外部の言語モデルなし)は、JSUT basic5000で6.4%、TEDxJP-10kで9.0%です。
ReazonSpeech k2 v2は159.34Mと、turboの5分の1ほどの大きさです。sherpa-onnxでCPUだけで動かせます。8GBのMacの字幕の欄に置いた理由は、小ささだけです。間に合う速さかは未測定で、判断表でいちばん根拠の薄いセルです。
道具を選ぶと、使える機材が決まります
モデルの次は、動かす道具です。ここを取り違えると「Macで動くはずが動かない」が起きます。
whisper.cppは、Apple Siliconを第一級でサポートしています(NEON・Accelerate・Metal・Core ML)。READMEには、Core MLでエンコーダをNeural Engineに載せるとCPUだけより3倍超速いとあります。Macなら、まずここです。マイク入力を書き起こし続けるstreamという「素朴な例」も入っています。
faster-whisperは、CTranslate2でWhisperを書き直したものです。READMEによれば、同じ精度でopenai/whisperより最大4倍速く、メモリも少なく済みます。最新版はCUDA 12とcuDNN 9が前提なので、NVIDIA GPUのPC向けです。
GPU PCの速さは、3月の記事に手がかりがあります。RTX 2000 Ada(16GB)で11モデルを測り、44秒の音声をFaster-Whisper large-v3は3,004ms、素のWhisper large-v3は5,510msで書き起こしました。テスト音声は英語なので、日本語の精度の根拠にはなりません。それでもGPU PCの英語混じりの欄にlarge-v3を置けたのは、この数字があるからです。44秒を3秒で処理できるなら、turboに落とす理由がない。
同じ44秒に、Moonshine mediumは89,512msかかりました。ストリーミング向けの設計で、まとめて流すと遅くなるためです。
sherpa-onnxは、ONNXに変換したモデルをCPUで動かせる道具です。Hugging Face上には、parakeet-jaのONNX変換版(int8とfp16)と、reazonspeech-k2-v2のsherpa-onnx向けの版が公開されています(csukuangfj名義、2026年11月4日確認)。GPUがなくても日本語専用モデルを試せます。速さは未測定です。
最後は、自分の会議録音10分で決めます
この節の要点: 10分の録音を手で書き起こして正解を作り、候補2つに同じ録音を書き起こさせて、CERと処理時間を比べる。順位表より、この1回のほうが当てになる。
測る前に、順位表を読むときの2つの言葉、CERとRTFを定義しておきます。
CER(文字誤り率)は、正解の文字数に対して、置換・脱落・挿入された文字の割合。RTF(実時間係数)は、処理時間÷音声の長さで、1未満なら録音より速く書き起こせる。
8GBのM2のturboは、RTFで言えば1を超えていたことになります(推定)。順位表を読むときは、もう1つ注意があります。
読み上げ音声のベンチマークで上位のモデルが、会議や放送のような自然な話し言葉でも上位とは限らない。Whisper系のモデルは、同じ語を繰り返し出し続ける“暴走”を起こすことがあるので、平均の誤り率だけで決めない。
私の数字も、まさに読み上げ音声です。14.84%だったturboが、空調の音と相づちと言いよどみの入った会議でどうなるかは分かりません。
判断表で候補は1つか2つに絞れました。最後の1つは、あなたの会議の録音で決めます。手順は4つです。
- ふだんの会議から10分を切り出す(社外の人の声が入らない社内会議がよい)
- その10分を、人の手で書き起こして正解のテキストを作る
- 候補のモデルに同じ10分を書き起こさせ、処理時間を測る
- 正解とモデルの出力からCERを計算する
いちばん手間がかかるのは2です。けれどもここを省いて「読んで自然だった」で決めると、固有名詞の誤りや抜けた発言に気づけません。
3のコマンドは、各READMEにある形だけを使います。whisper.cppは、ビルドしてモデルを取得し、16kHzのWAVに変換してから書き起こします。下の1〜2行目はリポジトリを取得、3行目でturboのモデルを取得、4〜5行目でビルド、6行目で録音をWAVに変換、7行目で書き起こしです。
git clone https://github.com/ggml-org/whisper.cpp.git
cd whisper.cpp
sh ./models/download-ggml-model.sh large-v3-turbo
cmake -B build
cmake --build build -j --config Release
ffmpeg -i input.mp3 -ar 16000 -ac 1 -c:a pcm_s16le output.wav
time ./build/bin/whisper-cli -m models/ggml-large-v3-turbo.bin -f output.wav
whisper-cliは16ビットのWAVしか受け付けないので、6行目の変換が要ります。言語の指定などの細かいオプションは、READMEが案内している ./build/bin/whisper-cli -h で確かめてください。日本語の録音なら、言語の設定が日本語になっているかを最初に見ます。
GPU PCでfaster-whisperを使う場合は、READMEのコードを次のように使います。language はREADMEの例と同じ引数で、値を日本語の "ja" にしています。
from faster_whisper import WhisperModel

model = WhisperModel("large-v3", device="cuda", compute_type="float16")
segments, info = model.transcribe("audio.mp3", beam_size=5, language="ja")
segments = list(segments)  # ここで書き起こしが実際に走る
for segment in segments:
    print("[%.2fs -> %.2fs] %s" % (segment.start, segment.end, segment.text))
時間を測るときは3行目に注意してください。READMEによれば segments はジェネレーターで、取り出すまで書き起こしは始まりません。transcribe の行だけを計ると、一瞬で終わったように見えます。
4のCERは、正解とモデルの出力の編集距離を、正解の文字数で割れば出ます。次の短いPythonで計算できます。空白と改行は除き、句読点の扱いは両方でそろえてから比べてください。
import sys

def cer(ref, hyp):
    ref = "".join(ref.split()); hyp = "".join(hyp.split())
    prev = list(range(len(hyp) + 1))
    for i, r in enumerate(ref, 1):
        cur = [i]
        for j, h in enumerate(hyp, 1):
            cur.append(min(prev[j] + 1, cur[j - 1] + 1, prev[j - 1] + (r != h)))
        prev = cur
    return prev[-1] / len(ref)

ref = open(sys.argv[1], encoding="utf-8").read()
hyp = open(sys.argv[2], encoding="utf-8").read()
print(f"CER: {cer(ref, hyp):.2%}")
python cer.py 正解.txt 出力.txt のように2つのファイルを渡します。
CERの平均だけで決めず、出力を流し読みして同じ語が何行も続く箇所がないかも見ます。1回の暴走が、議事録の穴になります。
費用だけなら、APIのほうが安く済みます
ここまでローカルの話をしてきましたが、費用だけで比べるとAPIはかなり安いです。OpenAIの料金ページ(2026年11月4日確認、税別)の分単価を、1ドル157.54円で円にしました。
| API | 単価 | 1時間あたり(推定) | 月20時間の会議(推定) |
|---|---|---|---|
| gpt-4o-mini-transcribe | $0.003/分 | 約28円 | 約567円 |
| gpt-transcribe | $0.0045/分 | 約43円 | 約850円 |
| gpt-4o-transcribe/Whisper(API) | $0.006/分 | 約57円 | 約1,134円 |
為替は三菱UFJ銀行の2026年10月30日の公表仲値(TTM)です。話者を分けて書き起こすgpt-4o-transcribe-diarizeも$0.006/分、ライブ文字起こしのgpt-live-transcribeは$0.017/分(1時間あたり約161円、推定)です。
月20時間を全部書き起こしても、千円前後です。ローカルを選ぶ理由は、安さではありません。「録音を外に出せない」「オフラインで使いたい」「毎日大量に回す」のどれかです。社内の会議には、取引先の名前や未発表の数字が普通に出てきます。録音を外部のAPIに送ってよいかは、精度より先に社内のルールで決まります。
費用の考え方はローカルLLMの費用の記事に書きました。
入れる前に、自分の条件を7つ確かめます
どのセルに当たるかは、次の7つで決まります。
- [ ] 録音を外部のAPIに送ってよいか、社内のルールを確かめた
- [ ] 機材のメモリ量(8GB/16GB)とGPUの有無を確かめた
- [ ] 用途を「議事録」「字幕」「英語混じり」から1つ決めた
- [ ] 英訳まで欲しいかを確かめた(英訳ならturboではなくlarge-v3)
- [ ] 商用なら、ライセンス(CC-BY-4.0は表示義務あり)を確かめた
- [ ] ふだんの会議から10分を切り出し、正解の書き起こしを作った
- [ ] 候補2つのCERと処理時間を測り、暴走していないかを流し読みした
落とし穴は、数字の読み違いに集まります
つまずきやすい点を3つ挙げます。
1つ目は、出どころの違う誤り率を並べることです。私のturboの14.84%は合成音声10本、ParakeetのJSUT 6.4%はモデルカード自身の評価です。音声も条件も違うので、「Parakeetのほうが2倍正確」とは読めません。言えるのは、同じ録音を同じ人が測ったときだけです。
2つ目は、turboに翻訳を頼むことです。WhisperのREADMEは、turboは翻訳タスク用に学習されていないと書いています。英語の会議を日本語で読みたい、あるいは日本語を英訳したいなら、large-v3かmediumを選びます。
3つ目は、モデルの名前の取り違えです。NVIDIAのParakeet-TDT-0.6B-v3やCanaryは日本語に対応していません。日本語版は別のチェックポイント、parakeet-tdt_ctc-0.6b-jaです。名前が似ていても、モデルカードの対応言語を必ず見てください。
正確さ・Macの速度・録音の扱い・ライセンスの答え
Q1. 日本語の音声認識は、Whisperが一番正確?
A. 音声の種類で順位が入れ替わるので、一番とは言えません。以前合成音声で測ったときは、large-v3が15.96%、turboが14.84%でほぼ同じでした。日本語専用モデルのモデルカードの値とは条件が違うので、自分の会議録音10分で比べるのが確実です。
Q2. Macの16GBで、実用的な速さで動く?
A. 動きます。以前の記事で、M5の16GBではturboが1サンプル平均0.61秒、large-v3が4.70秒でした(合成音声・MLX)。8GBのM2でもturboは動きましたが、平均8.90秒で音声の長さを上回りました。
Q3. 会議の録音を外に出さずに議事録にできる?APIと何が違う?
A. できます。この記事の5モデルはどれも手元で動き、録音は外に出ません。APIは月20時間の会議で約567〜1,134円(推定)と安い一方、録音を外部に送ります。ローカルは手間がかかる代わりに、外に出せない録音も扱えます。
Q4. 商用で使ってよいライセンスはどれ?
A. 5モデルとも商用で使えるライセンスです。WhisperはMIT(GitHub)、Kotoba-Whisper v2.0とReazonSpeech k2 v2はApache-2.0、parakeet-tdt_ctc-0.6b-jaはCC-BY-4.0で、CC-BYは出典の表示が条件です。Whisper large-v3はHugging Faceのモデルカードの表記がapache-2.0でGitHubと違うので、社内の審査では両方を示すと話が早く済みます。
自分の録音で測るまで、判断表は仮の答えです
「どのモデルを入れればいいの?」への答えは、Macならturbo、NVIDIA GPUのPCで日本語を大量に回すならParakeetも候補、でした。
ただ、その根拠は合成音声と公式の情報です。残った問いは、あなたの会議でturboの誤り率がどこまで上がり、Parakeetがそれを下回るかです。その答えは、10分の録音が持っています。
関連記事
- ローカルLLM完全ガイド
- Gemma 4 E2B vs Whisper:8GBのApple Siliconで日本語の文字起こしを比べた
- Gemma 4 vs Whisper:M5 16GBでの続編
- Moonshine Voice v2 vs Whisper:11モデルの実測比較
- TypeWhisper:ローカルで日本語を音声入力する
- VibeVoice:Microsoftの音声モデルの使い方
- ローカルLLMの費用はいくら?
- 16GB Macで日本語ローカルLLMはどれを選ぶか
参考・確認日
- OpenAI Whisper(GitHub)・whisper-large-v3・whisper-large-v3-turbo(2026年11月4日確認)
- Kotoba-Whisper v2.0 モデルカード(2026年11月4日確認)
- parakeet-tdt_ctc-0.6b-ja モデルカード(2026年11月4日確認)
- ReazonSpeech k2 v2 モデルカード・ReazonSpeech(公式)(2026年11月4日確認)
- whisper.cpp(GitHub)・faster-whisper(GitHub)・sherpa-onnx(GitHub)(2026年11月4日確認)
- OpenAI Pricing(2026年11月4日確認、税別)
- 三菱UFJリサーチ&コンサルティング 外国為替相場(2026年10月30日の公表仲値)
更新履歴
- 2026-11-04 公開用に作成。モデルカード・README・料金は2026-11-04確認、為替は2026-10-30の値。新しい実測はなし(実測は2026年3月・4月の公開済み記事のもの)。
コメント